Arkitektur
PDQ kombinerar avancerad automation med end-to-end aktiv metadatahantering. Det är grunden för dataoperationer som är effektiva, transparenta och fullt automatiserade.
Genom att integrera PDQ i din infrastruktur säkerställer du att modellering, kvalitet, versionering, integration, kodgenerering och orkestrering hänger ihop som en enhet — inte som en samling löst kopplade verktyg.
Från källa till levererat värde
Ingest, Data Lake Service och Data Warehouse Automation i ett sammanhängande flöde — med katalog, orkestrering, automatisering, observerbarhet och spårbarhet över hela kedjan.
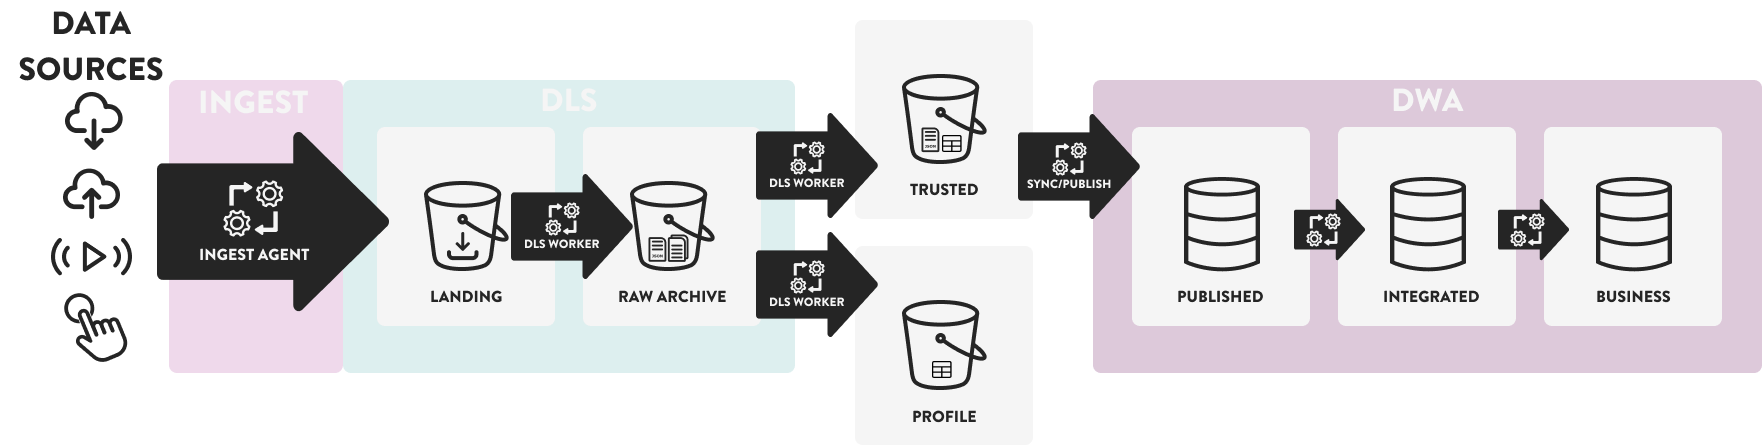
PDQ:s referensarkitektur. Varje steg är styrt av aktiv metadata, vilket gör flödet spårbart från datakälla till levererad rapport.
Samma flöde ritas live på PDQ:s dashboard, utifrån de system, källfiler och modeller som faktiskt är konfigurerade i din installation. Heldragna linjer är leveranser via Ingest-agenten, streckade linjer är direktöverföringar, och ikonen på varje källa visar om det är en databas, ett API, en filkälla, en egen koppling eller en manuell leverans.
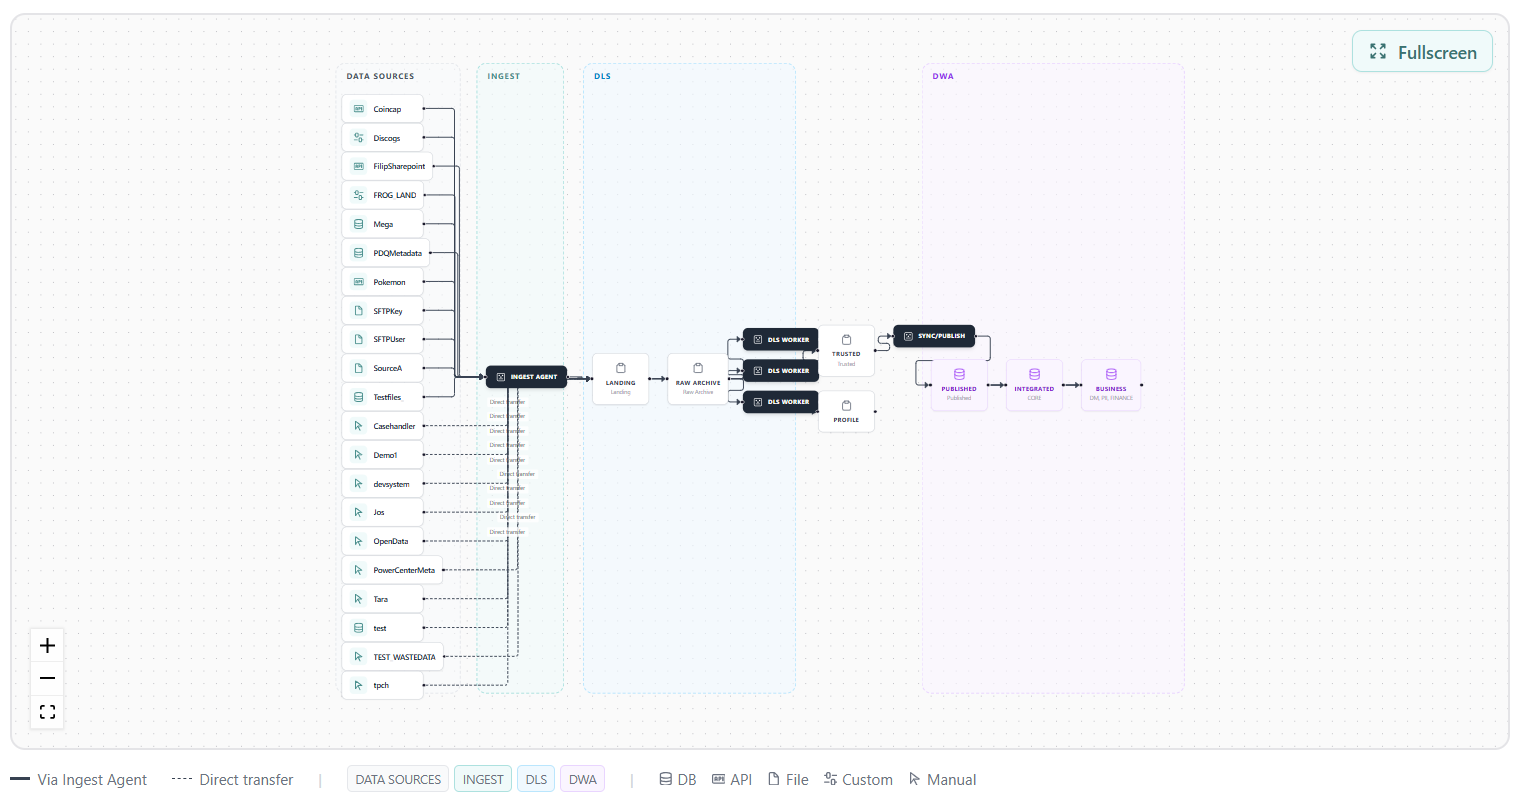
Varje steg har ett eget ansvar. Det gör att ett fel går att placera, och att ett lager går att byta utan att resten skrivs om. Metadatan styr körningen: härkomst, versioner och regelefterlevnad blir biprodukter av flödet i stället för separata projekt.
Stegen i detalj
Källor — Datakällor
Vad Filer, API:er, strömmar och databaser — källsystemen som de faktiskt ser ut, utan förarbete.
Varför Källor ändrar sig utan att fråga. Plattformen måste tåla det utan att någon skriver om en pipeline.
Hur Varje källa beskrivs som metadata: anslutning, schema och laddningsfönster. En ny källa är en konfiguration, inte ett projekt.
Ingest — Ingest Agent
Vad Agenten hämtar data och lägger den i Landing utan att förändra den.
Varför Det som anlände måste gå att skilja från det vi gjorde med det. Annars går ingen avstämning att göra i efterhand.
Hur Agenten kör nära källan, skriver oförändrade filer och stämplar varje leverans med tidpunkt och ursprung.
DLS — Data Lake Service
Vad Landing → Raw Archive → Trusted, med Profile vid sidan om.
Varför Rådata bevaras oförändrad medan normaliseringen sker på vägen mot Trusted. Två olika jobb, två olika lager.
Hur Profilering och kvalitetsregler körs som en del av flödet och registrerar avvikelser mot datakontraktet — se Vad plattformen registrerar, och vad den stoppar.
DWA — Warehouse Automation
Vad Published → Base → Core → Business. Från den inlästa leveransen till en integrerad, historiserad modell och slutligen ett affärsnära leveranslager.
Varför Core är kärnan: en normaliserad och historiserad modell där varje värde har en giltighetsperiod. Det är den som gör frågan "vad visste vi då?" besvarbar.
Hur Modellen är källan. Laddningslogik, historisering och tidpunktsvyer genereras ur den — ingen skriver historiseringslogik för hand.
Leverans — Ut till verksamheten
Vad Rapporter och BI, API:er, AI- och ML-arbetsflöden samt direkt SQL-åtkomst.
Varför Alla konsumenter läser samma kvalitetssäkrade underlag. En siffra — inte en siffra per verktyg.
Hur Affärslagret exponerar affärsnära vyer ovanpå den normaliserade modellen. Komplexiteten ligger närmast modellen, inte närmast användaren.
Aktiv metadata — Kapabiliteter runt hela kedjan
Vad Datakatalog, orkestrering, automatisering, observerbarhet och spårbarhet — observerbarheten omfattar både de löpande övervakningsvyerna och det spår de lämnar efter sig.
Varför De omger hela kedjan i stället för att sitta i var sitt verktyg. Metadatan beskriver inte bara systemet — den kör det.
Hur Aktiv metadata styr varje steg, så härkomst, versioner och regelefterlevnad faller ut ur körningen i stället för att dokumenteras vid sidan om.
Teknikagnostisk i grunden
Plattformen sitter ovanpå din stack — inte tvärtom.
Byt databas, byt lagring, byt moln. Modellen, logiken och metadatan följer med — det gör förhandlingsstyrkan mot leverantören verklig i stället för teoretisk.
Lagren är oberoende av varandra: byte av databas eller lagring är en konfigurationsändring, byte av moln en migrering.
| Lager | Alternativ som stöds |
|---|---|
| Valfri databas | Snowflake, Databricks, SQL Server, Synapse, Fabric, PostgreSQL |
| Valfri lagring | Azure Blob, Amazon S3, CEPH, Swift, MinIO |
| Valfritt moln | Azure, AWS, Cleura |
Vad plattformen faktiskt gör
Modellering och kodgenerering
Datamodellen är källan. Laddningslogik, historisering och strukturer genereras ur den — konsekvent oavsett vem som bygger, och utan handskriven ETL som glider ur synk över tid.
Styrning i målet, inte bredvid det
Samma genereringskörning som bygger tabellerna dokumenterar och klassificerar dem också. Kolumn- och tabellkommentarer, primärnycklar, främmande nycklar, unika villkor, kategoritaggar och känslighetstaggar genereras ur de deklarationer som redan gjorts i datakontraktet och modellen — så en klassificering som satts en gång på ett källfält anländer på målkolumnen, även på de normaliserade barntabeller som ärver nyckeln.
Kvalitet och profilering
Profilering och kvalitetsregler körs som en del av flödet, inte som ett efterarbete. Avvikelser fångas och registreras där de uppstår.
Orkestrering och drift
Beroenden, körordning, omkörningar och larm hanteras centralt. Produktionsklart från dag ett i stället för månader av ställningsbygge.
Orkestreringen är automatisk, och den vilar på tre saker:
- Late arriving dimension handling — nyckelgenerering, så att en transaktion som pekar på masterdata ingen ännu levererat ändå får en nyckel att hänga på.
- Modellberoenden — vad som måste laddas före vad, avläst ur modellen.
- Löst kopplade källor — en källa som är sen eller uteblir håller inte upp de källor som är klara.
Det är detta som gör att ingen behöver skriva en körordning för hand. Additional Tasks och QPI-kontroller kedjas på det automatiska flödet snarare än att ersätta det.
Load Group och Load Step är resultat av mappningarna, inte konfiguration. Mappningarna resulterar i ett schema, och det schemat har Load Groups och Load Steps i sig — en Load Group är till exempel alla attributladdningar, ett Load Step en enskild aktion i Base. Ingen av dem har någon maskinell funktion. De finns för att göra det begripligt hur laddningarna hänger ihop och i vilken ordning de inträffar, och för att gränssnittet ska gå att filtrera på dem.
En mappningsgrupp är något annat: en logisk gruppering av reglerna för en viss laddning, från en källa till x antal måltabeller.
Aktiv metadata
Metadatan beskriver inte bara systemet — den kör det. Härkomst, versioner och regelefterlevnad är biprodukter av körningen, inte separata projekt. Den är också portabel: REST-API:et serverar hela registret, och varje exekvering genererar OpenLineage-händelser, så härkomsten når den katalog du redan kör i stället för att stanna inne i konsolen.
Vad plattformen registrerar, och vad den stoppar
PDQ arbetar med discovery. Profilering och kvalitetsregler körs som en del av flödet och registrerar avvikelser mot datakontraktet — de blockerar inte leveransen. Ett fält som försvinner, ett fält som tillkommer, ett värde vars innehåll förändras: allt passerar, med avvikelsen loggad, eftersom vilka avvikelser som spelar roll avgörs av det användningsfall som konsumerar datat, inte av plattformen.
Två saker stoppas, vid olika punkter i kedjan. En korrupt fil stoppas i Raw och når aldrig Trusted; originalet bevaras i Raw Archive. En saknad primärnyckel stoppar modelladdningen i DWA — då har datat redan passerat Trusted och Published.
| Vad | Var | Konsekvens |
|---|---|---|
| Korrupt fil | I Raw | Når aldrig Trusted. Originalet bevaras i Raw Archive. |
| Saknad primärnyckel | Vid DWA-laddningen | Datat har redan passerat Trusted och Published. Modelladdningen sker inte. |
Trusted är alltså inte en kvalitetsgrind. Eftersom ingenting filtreras bort mellan zonerna betyder en avvikelse i filräkningarna att något fastnat, inte att något sorterats bort.
Expected är ett antagande gjort av en operatör eller utvecklare. Det är en hänvisning, inte ett facit — en avvikelse mot Expected betyder att antagandet eller leveransen behöver tittas på, inte att systemet felat.
Contract Validation
Registrerade avvikelser syns i Contract Validation, som är discovery-löftet i konkret form. Vyn rapporterar tre sorters avvikelse:
| Avvikelse | Vad den betyder |
|---|---|
| Data Type Mismatch | Värdena stämmer inte längre med den typ kontraktet anger. |
| Missing In Contract | Källan har börjat skicka något som kontraktet inte beskriver. |
| Missing In Delta | Källan har slutat skicka något som kontraktet beskriver. |
En begränsning är värd att känna till: vyn jämför dagens profildata mot kontraktet. Det är en nulägesbild, inte en historik över avdrift.
Modellkedjan
Kedjan är Published → Base → Core → DM. Varje steg har mer än ett namn, eftersom lagren motsvarar mönster som fått namn på annat håll först:
| Steg | Även kallat |
|---|---|
| Published | Bronze |
| Base | Ensemble Model |
| Core | Integrated, Silver |
| DM | Data Mart, Gold, Business |
Base är ett verkligt steg, och flödesbilderna ovan visar fortfarande tre. Data läses in i Published, integreras i Base med ensemble-modellering, konsolideras i Core och formas för ett användningsfall i DM.
DataOps-konsolen kallar det sista steget Data Mart i Data Lineage. Det väntas ändras; till dess skriver den här dokumentationen Business (Data Mart i konsolen) där konsolens etikett spelar roll.
Stage har utgått som namn. Inläsningssteget det brukade beteckna heter nu Published, och laddas med de tekniker som beskrivs i Målplattformar. Det är en omdöpning, inte en borttagning: mekanismen är densamma, lagret heter Published.
DLS och DWA — vad som händer var
| Steg | Lager | Vad som händer |
|---|---|---|
| Ingest | In i plattformen | Ingest-agenten hämtar data från filer, API:er, meddelandeköer och databaser och lägger den i Landing utan att förändra den. |
| DLS | Data Lake Service | Landing → Raw Archive → Trusted, med Profile vid sidan om. Rådata bevaras oförändrad; normaliseringen sker på vägen mot Trusted. |
| DWA | Data Warehouse Automation | Published → Base → Core → Business. Från den inlästa leveransen till integrerad, historiserad modell och slutligen affärsnära leveranslager. |
| Leverans | Ut till verksamheten | Rapporter, API:er, dashboards, AI- och ML-arbetsflöden samt direkt SQL-åtkomst — allt från samma kvalitetssäkrade underlag. |
Databehandlingslager
| Lager | Syfte |
|---|---|
| Landing | Ingångspunkten för data, där den initialt matas in. |
| Raw Archive | Lagrar rådata på obestämd tid, organiserad och märkt för revisionsändamål. |
| Trusted | Bearbetar och publicerar data i ett standardiserat, lättanvänt format. Hur många dagar bakåt en leverans finns kvar här för en Published-omkörning styrs av KEEPDATAINTRUSTEDFORDAYS — standard 3 dagar. |
| Profile | Analyserar data för att upptäcka nya och saknade datapunkter utan att störa laddningsprocessen. |
| Published | Tillhandahåller valt tabellformat för överenskommen källleverans och underlättar SQL-baserad dataåtkomst. |
| Base | Ensemble-integrationssteget, där källor slås samman på affärsnycklar. Även kallat Ensemble Model. |
| Core | En integrerad central affärskonceptdatamodell som använder ensemble-datamodelleringsmetodik. Även kallat Integrated eller Silver. |
| Business | Användningsfallsdrivna affärsdataset designade för specifika scenarier, anpassade efter unika affärs- och domänspecifika definitioner och regler. Även kallat DM eller Data Mart — konsolens Data Lineage-vy skriver Data Mart. |
Nästa steg
- Plattformsguide — hur lagren hänger ihop, med fördjupningen uppdelad på INGEST, DLS och DWA
- Kapabiliteter för datahantering — hela listan över vad plattformen gör, med länkar in i detaljerna
- Vad som landar i målmiljön — kommentarerna, nycklarna, villkoren, taggarna och maskeringen som genereras in i din databas
- Ditt första flöde — hela vägen från en källfil till en schemalagd dataprodukt
- Driftsättning — installera och kör plattformen i din egen miljö
- Daglig drift — övervakning och drift av plattformen