Data Lake Service (DLS)
Det här avsnittet ger vägledning om hur du definierar och hanterar inställningarna för en källfil, så att data överförs korrekt och effektivt från landningszonen till databasen.
Det här lär du dig här:
Källkonfiguration i UI: En guide till att konfigurera en källfil via Config UI. Det omfattar att definiera filstrukturen (datakontraktet) och de inställningar som styr hur varje leverans arkiveras och publiceras.
- Källkonfiguration i UI
- Kodkonfiguration
- Tekniska detaljer
Konfigurera källfilen via gränssnittet
Sidan DLS → Sources (/sourcefiles) definierar och hanterar inställningarna för en källfil: hur en inkommande leverans tolkas, var den arkiveras och hur den publiceras till den betrodda zonen.
Knappen Sources Guide överst på sidan fäller ut en kort sammanfattning av samma material direkt i appen.
Välja system och källa
Välj system i den sökbara listan och därefter källa inom det. Add new system och Add new source skapar nya poster.
Ändringar hålls i en arbetskopia tills du trycker på Save changes. Knappen visar No changes to save så länge formuläret är orört, en markering Unsaved changes dyker upp så snart du ändrat något, och webbläsaren varnar innan du stänger fliken med osparat arbete.
Åtgärdsraden innehåller också Show JSON (den exakta definitionen, med nedladdningsknapp), Schema Diagram (en visuell vy över filstrukturen) och Deactivate this source.
Lägga till en ny källfil
Add new source öppnar en dialog som frågar efter källfilens namn, filtyp, ett valfritt filnamnsmönster (lämna tomt för att återanvända källfilens namn) och en valfri beskrivning.
En källfil kan också skapas direkt från en export: när du sparat en exportdefinition på sidan INGEST → Exports erbjuder UI:t att skapa den matchande källfilen med namn, filtyp och filnamnsmönster redan ifyllda.
De två flikarna
Sourcefile Structure definierar filens hierarkiska struktur och relationerna mellan dess fält — datakontraktet som nedströmsprocesser och profilering validerar mot.
Sourcefile Properties innehåller metadata samt de arkiverings- och publiceringsinställningar som beskrivs nedan.
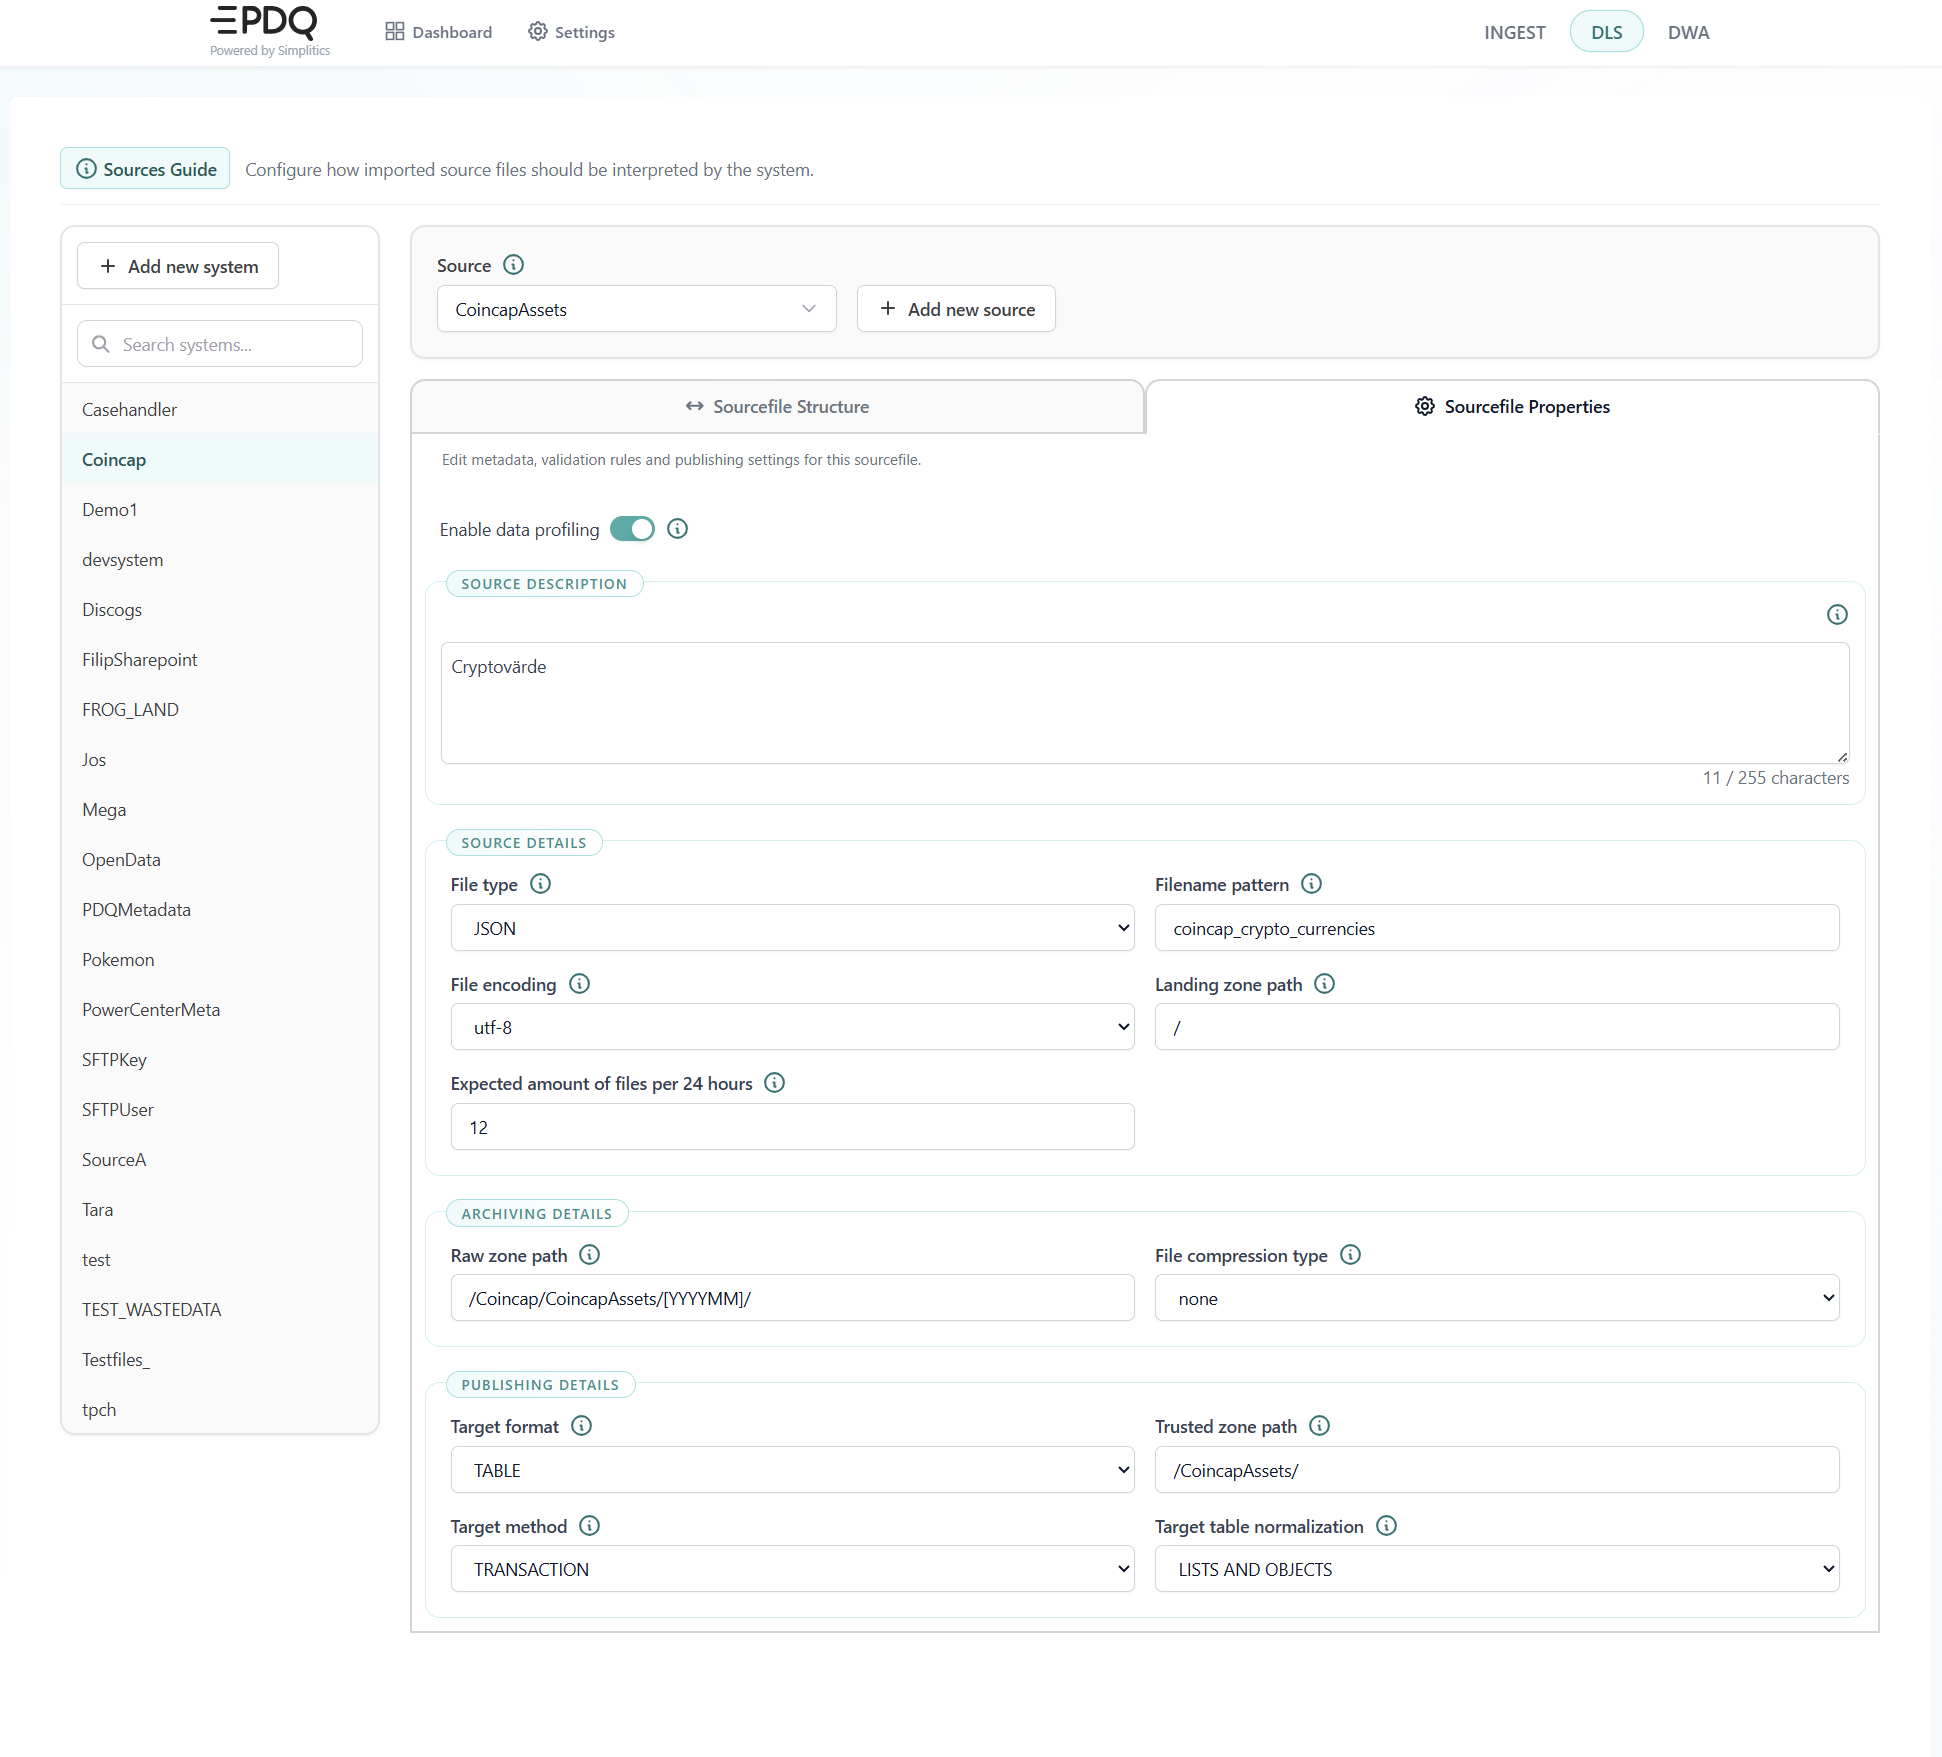
Sourcefile Properties
- CSV — kolumnavgränsad textdata.
- JSON — JSON-formaterad textdata.
- XML — XML-formaterad textdata.
- TABLE — klientdatabasens eget tabellformat.
- ICEBERG — Iceberg-tabellformat.
- JSON — radavgränsad JSON.
- APPEND — lägger till ändringar och nya poster i måltabellen. Metoden jämför inte inkommande data mot befintliga poster, så dubbletter av ändringsposter kan uppstå.
- OVERWRITE — inkommande data skriver över befintlig data.
- TRANSACTION — lägger till all inkommande data i måltabellen utan några kontroller.
- CHANGES ONLY — lägger till ändringar och nya poster och jämför inkommande data mot den senast kända ändringen i måltabellen, så att inga dubbletter av ändringsposter läggs till.
- LATEST VERSION — tillämpar ändringar och nya poster men behåller bara en version per primärnyckel.
- NONE — strukturen publiceras som den är.
- LISTS — repeterande listor bryts ut till egna tabeller.
- LISTS AND OBJECTS — både listor och nästlade objekt bryts ut.
Enable data profiling (enableProfiler): Aktiverar löpande kontroller och validering av inkommande data mot datakontraktet. Det rekommenderas att låta detta vara påslaget, men det ökar lagrad volym och förbrukar beräkningsresurser, så det kan stängas av vid behov.
Source description (description): Fritext som förklarar källfilens syfte och innehåll, upp till 255 tecken. Redigeraren visar teckenräknaren.
Source details
File type (fileType): Hur källdatan ska tolkas. Tillgängliga alternativ:
Data Modifier är komponenten inuti DLS som gör formatarbetet: den transformerar JSON, CSV och XML till en gemensam struktur, så att en leverans kan läsas via SQL nedströms oavsett vilket format den anlände i.
Filename pattern (filenamePattern): Den unika representationen av källfilens data, som används för att identifiera alla leveranser. Flera olika exporter kan skrivas in i en och samma källfil genom att dela mönster.
File encoding (fileEncoding): Teckenkodningen som används för att läsa de levererade filerna. Listan hämtas från plattformsinställningarna; standardvärdena är utf-8 (stödjer alla Unicode-tecken), utf-16 och windows-1252 (västeuropeiskt, kompatibelt med äldre Windows-program).
Landing zone path (landingZonePath): Knyter källfilen till en specifik uppladdningsmapp. Användbart när flera källor levererar data med liknande eller matchande filnamnsmönster, eller när olika autentiseringsuppgifter används mot uppladdnings-/landningsbucketen.
Expected amount of files per 24 hours (expectedAmount): Det förväntade antalet leveranser per dygn, som används som riktmärke för om en leverans är komplett. Standardvärdet är 0, vilket betyder att filen inte är förväntad; annars ett positivt heltal.
Archiving details
Raw zone path (rawZonePath): Där arkiverad rådata lagras. Standard är /<system>/<source>/[YYYY]/[MM]/[DD]/ när fältet lämnas tomt. Dynamisk formatering tillämpas utifrån leveransdatumet: [YYYY] fyrsiffrigt år, [YY] tvåsiffrigt år, [MM] månad, [DD] dag, [HH] timme. Dessa anges i UTC.
File compression type (fileCompressionType): gzip eller none. Talar om för DLS om data ska arkiveras och behandlas komprimerad. Nya källor får gzip som standard.
File compression level (fileCompressionLevel): Visas när typen är gzip. 1 till 9, där 9 är högsta komprimering.
Publishing details
Target format (targetFormat): Formatet som används när data publiceras till den betrodda zonen. Oavsett ursprunglig fileType konverteras data till:
Trusted zone path (trustedZonePath): Där publicerad, betrodd data lagras. Standard är /<system>/<source>/ när fältet lämnas tomt. Samma dynamiska datumformatering som för raw zone path gäller.
Target method (targetMethod): Hur ny data skrivs till trusted zone path:
Hur länge Trusted går att köra om från
KEEPDATAINTRUSTEDFORDAYS anger hur många dagar bakåt Published kan köras om från utan att
processa om från Raw. Standard är 3 dagar.
Det är en prestandainställning, inte en retention som rensar Trusted i största allmänhet. Inom fönstret läser en Published-omkörning det som redan finns i Trusted och går snabbt. Utanför fönstret måste samma omkörning gå tillbaka till råarkivet och bearbeta framåt igen, vilket kostar i motsvarande grad. Publisher Trace stänger av Restart för en fil som är äldre än fönstret av just det skälet, och hänvisar till DLS Trace i stället.
Att höja värdet ger billigare omkörningar längre bakåt, till priset av lagring. Att sänka det gör tvärtom. Ingenting går förlorat i något av fallen: råarkivet är permanent.
Hur ett fälts typ avgörs
När ett datakontrakt genereras avgörs ett fälts typ över filnycklarna efter preferens:
Varchar > Decimal > Integer > Timestamp > Date > Time
Den vidaste typen vinner, så ett fält som kom som heltal i en leverans och som text i en annan typas som text i stället för att fälla den senare leveransen.
Target table normalization (targetNormalization): Hur källstrukturen normaliseras till måltabeller:
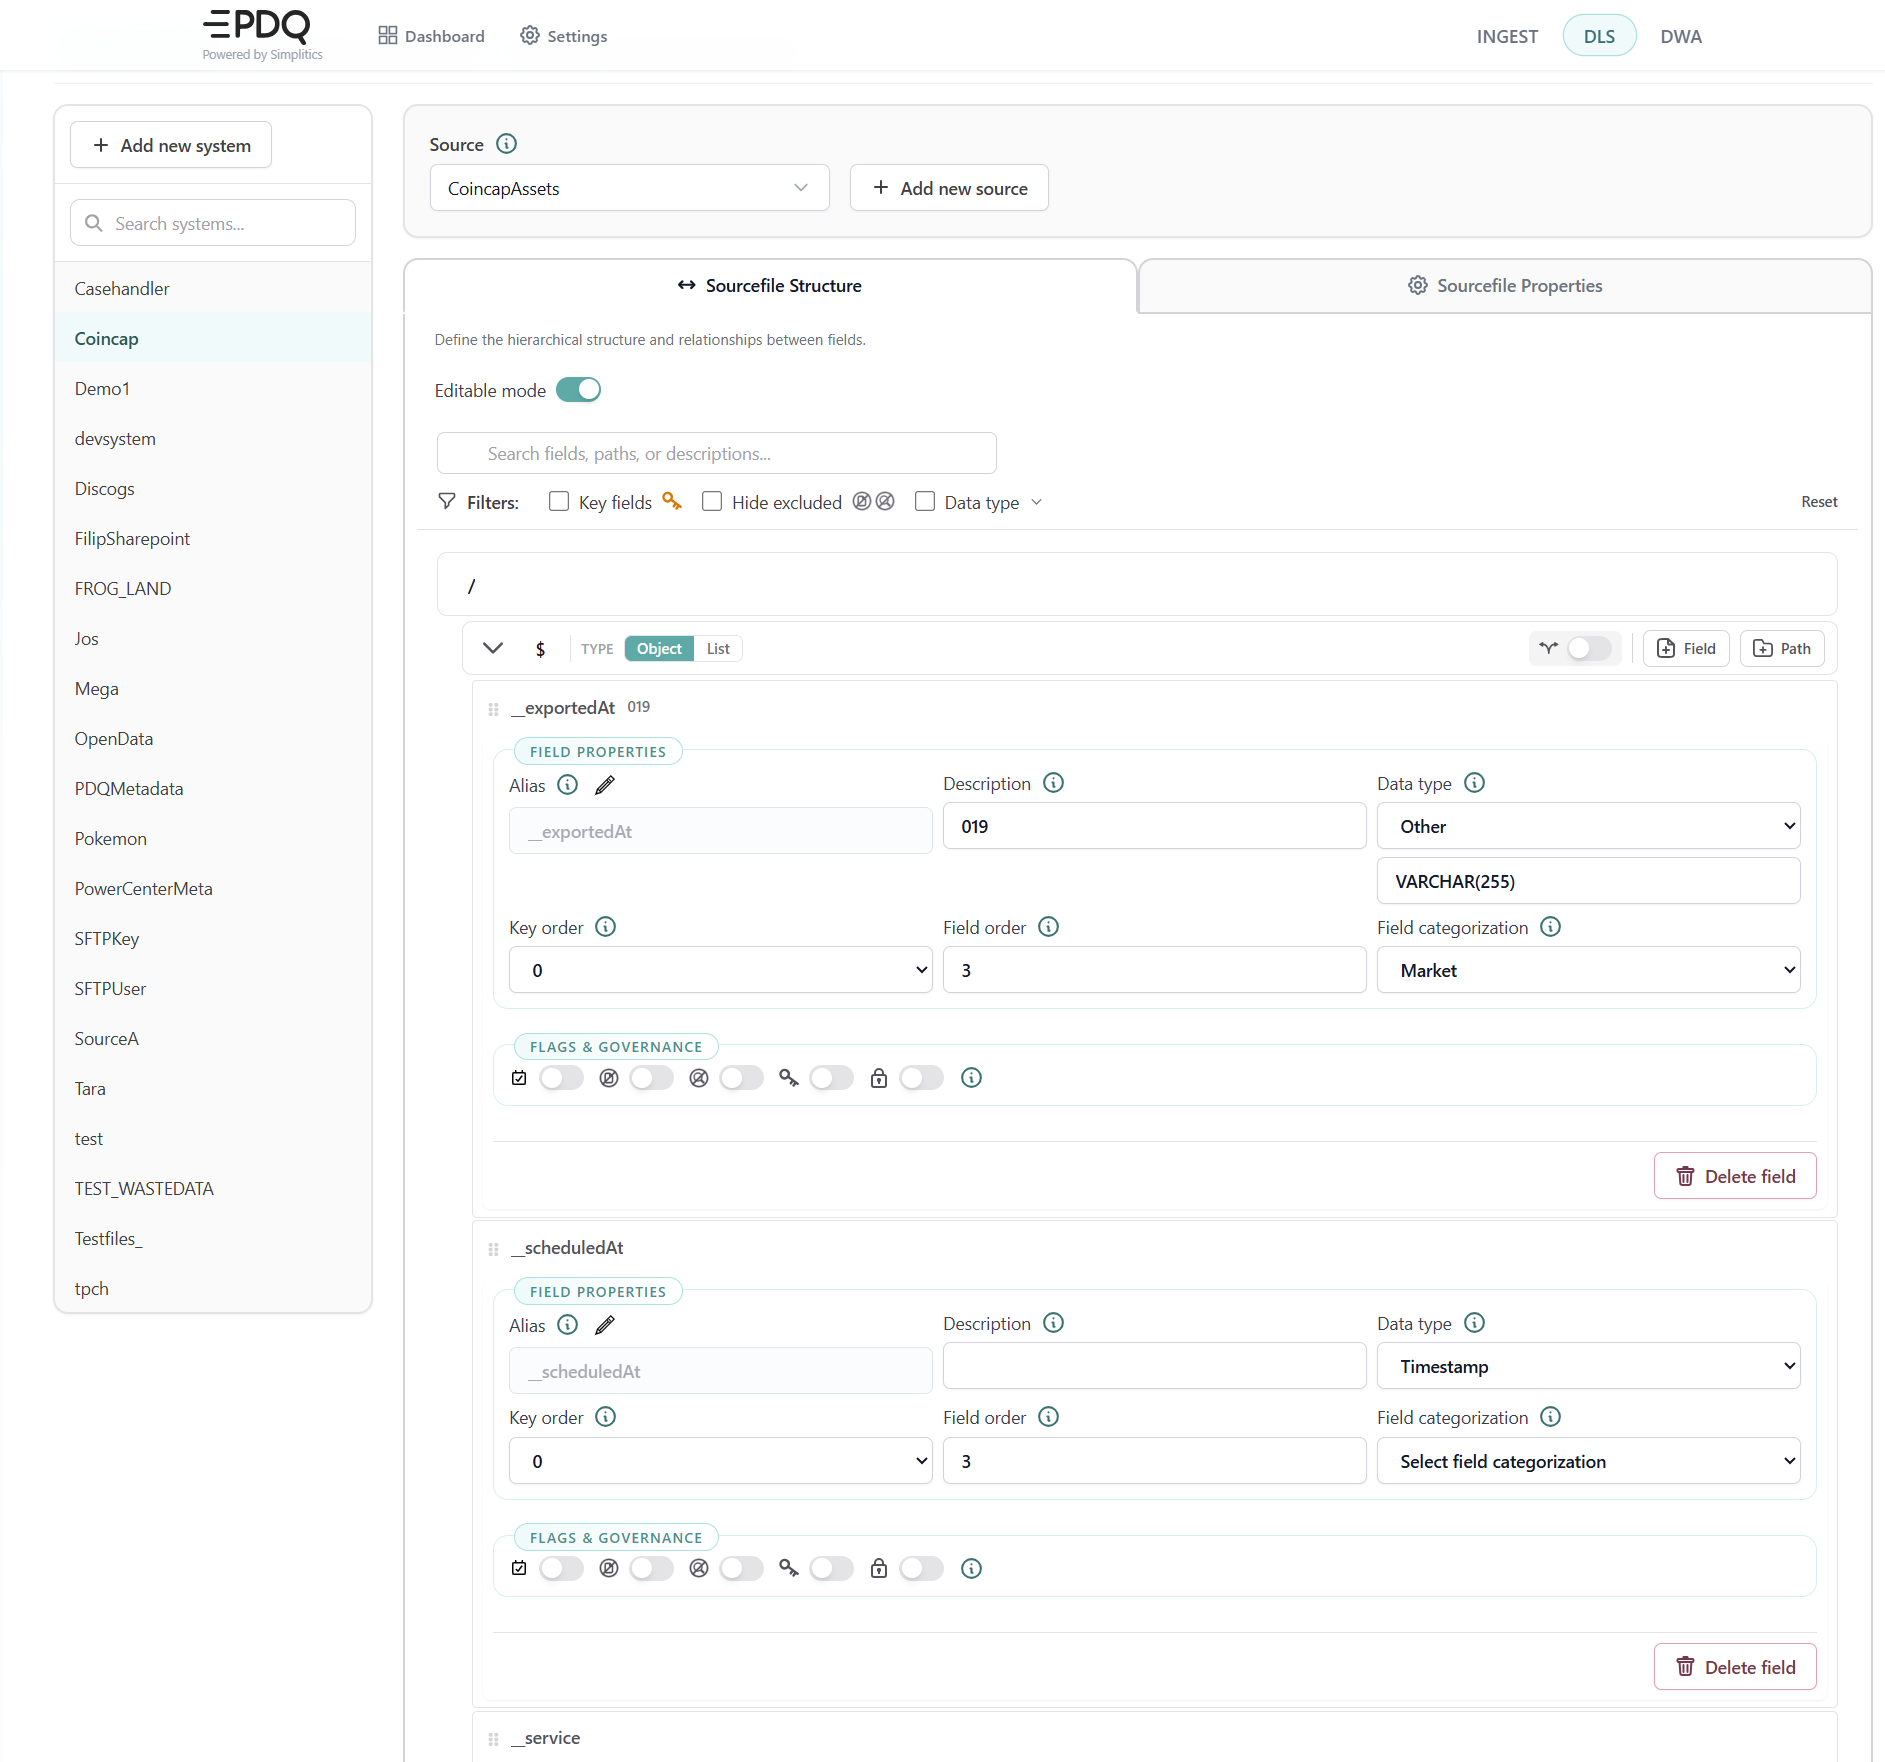
Sourcefile Structure
- Alias (
fieldAlias): namnet som används för fältet nedströms, när källans namn inte är det namn du vill ha i måltabellerna. - Beskrivning: fritext som följer med in i den genererade dokumentationen — och in i
COMMENTpå målkolumnen. - Datatyp: den deklarerade typen, till exempel
VARCHAR(255)ellerTimestamp. - Key order: fältets position i nyckeln.
0betyder att fältet inte ingår i nyckeln. - Field order: fältets position i måltabellen.
- Field categorization: den affärskategori fältet tillhör.
- Flags & governance: växlar per fält som styr inkludering, exkludering, nyckeltillhörighet och skydd.
Fliken Sourcefile Structure innehåller själva datakontraktet: källfilens hierarkiska struktur och egenskaperna för varje fält. Slå på Editable mode för att ändra det.
Varje fält bär:
Använd filtren ovanför listan för att bara visa nyckelfält, dölja exkluderade fält eller begränsa listan efter datatyp.
Det du sätter här följer med till målet. Datakontraktet är inte dokumentation om flödet — det är indata som generatorn använder för att bygga tabellerna. Beskrivningen blir en kolumnkommentar, nyckelordningen blir en primärnyckel på publiceringstabellen och ett unikt villkor på core-tabellen, fältkategoriseringen blir en kategoritagg på målkolumnen, och ett fält flaggat sensitive får en känslighetstagg och, på plattformar som stödjer det, en kolumnmask. På en hierarkisk källa följer en affärsnyckels klassificering med nyckeln till varje normaliserad barntabell som ärver den. Se Vad som landar i målmiljön.
Observera att fieldKey och path är skiftlägeskänsliga och måste matcha källfilerna exakt.
Hämta in ny data och förbereda den för Trusted
En steg-för-steg-guide genom dataflödet, inklusive hur du sätter upp Data Lake Service (DLS) by Simplitics och hämtar in data från landningshinken till staginghinken för Trusted.
För att sätta upp en ny datakälla behöver du skapa en instruktions-JSON. Varje källfil måste kopplas till ett fördefinierat källsystem, och datan måste identifieras med ett unikt filmönster.
Kontrollera om källsystemet redan finns:
Är källfilen kopplad till ett befintligt källsystem?
Ja: Hoppa till Steg 2.
Nej: Följ Steg 1.
Steg 1: Definiera ett nytt källsystem
Bygg en JSON-definition enligt följande mall:
{
    "system": "NewSystemName",
    "description": "This system handles all example data"
}
Beskrivning av parametrar för källsystem
system: Representerar systemet i DLS-spårningen och ska ges ett unikt namn i ett ord.
description: En textuell förklaring av källsystemets syfte. Beskrivningen visas genomgående i systemdokumentationen.
Steg 2: Definiera en ny källfil
CSV: Kolumnavgränsad textdata.JSON: JSON-formaterad textdata.XML: XML-formaterad textdata.
fileEncoding: Teckenkodningen som används för att läsa de levererade filerna, till exempelutf-8,utf-16ellerwindows-1252. Listan över verifierade kodningar hämtas från plattformsinställningarna.
enableProfiler: Antingen1(aktiverad) eller0(avstängd). Rekommendationen är att hålla den aktiverad för att löpande kontrollera och validera inkommande data mot datakontraktet. Observera att detta ökar lagrad volym och förbrukar beräkningsresurser.
fileCompressionType: Anger om datan ska komprimeras. Alternativen ärgzipellernone.
fileCompressionLevel: Komprimeringsnivån, där9är den högsta tillgängliga.
enableEncryption: Aktiverar standardkryptering på lagringssidan för all data.
expectedAmount: Det förväntade antalet leveranser per dygn, som används som riktmärke för om en leverans är komplett. Standardvärdet0betyder att filen inte är förväntad.
landingZonePath: Definierar en särskild uppladdningsmapp för källfilens data i landningshinken. Användbart om flera källor levererar data med liknande eller matchande filnamnsmönster, eller om olika autentiseringsuppgifter används för uppladdnings-/landningshinken.
rawZonePath: Mappstrukturen för råarkivet. Detta håller arkivet navigerbart. Standard är/<system>/<source>/[YYYY]/[MM]/[DD]/. Dynamisk formatering baserad på leveransdatum kan användas:[YYYY]: Four-digit year (e.g., 2023).[YY]: Two-digit year (e.g., 23).[MM]: Two-digit month (e.g., 08).[DD]: Two-digit day (e.g., 09).[HH]: Two-digit hour (e.g., 02).
Observera: dessa anges i UTC.
trustedZonePath: Mappstrukturen i den förberedda staginghinken. Standard är/<system>/<source>/. Dynamisk formatering enligt ovan kan också användas.
targetMethod: Metoden som används för att skriva ny data tilltrustedZonePath. Alternativen är:TRANSACTION: Lägger till all inkommande data i måltabellen utan några kontroller.APPEND: Lägger till ändringar och nya poster i måltabellen. Observera att dubbletter av ändringsposter kan uppstå, eftersom metoden inte jämför inkommande data mot befintliga poster.CHANGES ONLY: Lägger till ändringar och nya poster och jämför inkommande data mot den senast kända ändringen i måltabellen, så att inga dubbletter av ändringsposter läggs till.LATEST VERSION: Tillämpar ändringar och nya poster på måltabellen och behåller bara en version per primärnyckel.OVERWRITE: Inkommande data skriver över befintlig data.
targetFormat: Tabellformatet som används för att publicera data. Oavsett ursprungligtfileTypekonverteras datan till:TABLE: Klientdatabasens eget tabellformatICEBERG: Iceberg-tabellformatJSON: Radavgränsad JSON
targetNormalization: Hur källstrukturen normaliseras till måltabeller. En avNONE,LISTSellerLISTS AND OBJECTS.
fileStructure: Representerar hela källfilens struktur, inklusive alla kolumner, attribut, taggar, hierarkier och listor med deras datatyper och egenskaper. Detta används för att automatisera nedströmsprocesser och validera källdatans kvalitet. Det utgör datakontraktet i DLS. Inledningsvis kanfileStructurevara en tom lista[]. DLS fungerar utan den, men nedströmsoperatorerna gör det inte.- Använd API-definitionen i Swagger:
/api/v3.2/sourcefiles/:sourceFilename. - Ersätt
:sourceFilenamemed det faktiska namnet på din källfil.
Bygg en JSON-definition enligt följande mall.
  {
      "system": "NewSystemName",
      "sourceFilename": "NewSourceFile",
      "description": "Orders delivered nightly by the ERP",
      "filenamePattern": "unique.filepattern",
      "fileType": "JSON",
      "fileEncoding": "utf-8",
      "enableProfiler": 1,
      "fileCompressionType": "gzip",
      "fileCompressionLevel": 9,
      "enableEncryption": 1,
      "expectedAmount": 0,
      "landingZonePath": "Upload/Here/",
      "rawZonePath": "NewSystemName/NewSourceFile/[YYYY]/[MM]/[DD]/",
      "trustedZonePath": "NewSourceFile/",
      "targetMethod": "LATEST VERSION",
      "targetFormat": "TABLE",
      "targetNormalization": "NONE",
      "fileStructure": []
  }
Beskrivning av parametrar för datainhämtning
system: Det internt tilldelade namnet på det källsystem som källfilen hör till.
sourceFilename: Representerar källfilen i DLS-spårningen och ska ha ett unikt namn i ett ord.
description: Fritext som förklarar källfilens syfte och innehåll. Begränsad till 255 tecken i UI:t.
filenamePattern: Den unika identifieraren för källfilens data, som används för att känna igen alla leveranser i landningshinken.
fileType: Definierar hur källdatan ska tolkas. Format som stöds:
Ladda upp definitionen till DLS:
Steg 3: Validera genom att ladda en datamängd
Ladda upp en fil som representerar källdatan till landningshinken och den angivna mappen i hinken. Processen plockar automatiskt upp filen, tar bort den från landningshinken, arkiverar datan enligt beskrivningen i råarkivet och formaterar om datan enligt instruktionerna samtidigt som en kopia skrivs till trusted-zonen. Validera slutligen resultatet för att säkerställa att datan bearbetats korrekt.
Driftsätta en definition till produktion
- Exportera eller spara definitioner: Exportera eller spara definitionerna till disk i repositoryt. Knappen Show JSON på Sources-sidan laddar ner den aktuella definitionen.
- Skapa en feature-gren: Förgrena till en feature-gren.
- Skapa en pull request: Skapa en pull request för ändringarna.
- Kör API-anrop: Utgå från listan över ändrade objekt och kör API-anropet för vart och ett.
- Automatisera med CI: Bygg en pipeline som automatiserar uppgifterna ovan.
Rekommenderad metod
Alternativ metod
Upprepa utvecklingsstegen manuellt i produktionsmiljön.
DLS
Runs as several containers (minimum 6). Built using Docker. Python 3.12 on Debian 12.
Code in bitbucket, containers published on docker hub.
Python-beroenden, requirements.txt
azure-commonazure-identityazure-storage-blobazure-storage-commonazure-mgmt-resourceazure-mgmt-datalake-storeazure-datalake-storeazure-storage-queueazure-storage-file-datalakepyodbcredissqlalchemypandaspytzpyyamlboto3ijsonxmltodict
Driftsättning och körning
- Applikationen kan köras i vilken containerbaserad miljö som helst. Det är att föredra att köra den i samma molnkonto, men det är inget hårt krav.
- Applikationen genererar ingen kod. Den använder JSON-baserad konfiguration som indata och utnyttjar streaming-bibliotek från AWS eller Microsoft för att bearbeta data.