Inmatning
Det här avsnittet ger vägledning om hur man konfigurerar anslutningar, exporterar data, automatiserar dataextraktion och förstår de tekniska specifikationerna för INGEST-komponenten.
Det här lär du dig här:
Anslutningar: Hur du konfigurerar en anslutning till ett källsystem på sidan INGEST → Connections i Config UI. Det omfattar att registrera ett nytt källsystem, välja anslutningstyp och operator, tillämpa en konfigurationsmall och ange autentiseringsuppgifter.
Exporter: Hur du konfigurerar en exportdefinition på sidan INGEST → Exports. En export läser en tabell, en endpoint, en katalog eller en kö och skriver resultatet till landningszonen.
Kodkonfiguration: En guide för att automatisera dataextraktion och laddning till landningszonen enligt ett schema när användning av UI:t inte är genomförbart. Avsnittet täcker JSON-definitionerna och de API-endpoints de skickas till.
Tekniska detaljer: Detaljerad information om de tekniska specifikationerna för INGEST-komponenten, inklusive containerinställning, Python-beroenden och distributions- och exekveringsriktlinjer.
- Anslutningar
- Exporter
- Code Setup
- Tekniska detaljer
Konfigurera anslutningen via UI
Sidan INGEST → Connections (/systems) definierar hur PDQ når ett källsystem. Systemen listas i den sökbara sidopanelen till vänster; när du väljer ett öppnas dess anslutning, och Add new system skapar ett nytt.
Överst på sidan finns knappen Connections Guide som fäller ut en kort sammanfattning av samma material direkt i appen.
Lägga till ett nytt system
Ett system är den logiska källa som allt annat hänger på — anslutningar, exporter, källfiler och mappningar refererar alla till det med namn.
Källsystemets namn (system): Ett unikt namn i ett ord som representerar källsystemet. Namnet används internt för spårning och hantering av data från källsystemet och kan inte ändras i efterhand.
Källsystemets beskrivning (description): En textuell förklaring av källsystemets sammanhang och detaljer. Beskrivningen visas genomgående i systemdokumentationen.
Välja anslutningstyp
- DB — en relationsdatabas som nås med SQL.
- API — en HTTP-endpoint som returnerar JSON.
- FILE — ett filsystem: lokal disk, S3, Azure Data Lake Gen2 eller SFTP.
- CUSTOM — allt annat. I dag är det köfamiljen (SQS, Azure Service Bus, Redis) plus den enkla custom-mallen.
Ett system som ännu inte har någon anslutning visar de fyra anslutningstyperna som knappar. Typen avgör vilket kontrakt anslutningen sparas under och vilket formulär du får:
När en anslutning väl finns är typen låst, och rubriken visar operatorn tillsammans med märket Connected.
Välja operator
Inom en anslutningstyp kör inmatningsmotorn exakt en operatorklass per källsystem. Operatorn avgör vilka fält som läses, vilka som krävs och vilka som ignoreras — formuläret frågar därför bara efter det som operatorn behöver, markerar det som krävs och flaggar det som kommer att ignoreras i stället för att dölja det.
| Typ | Operatorer |
|---|---|
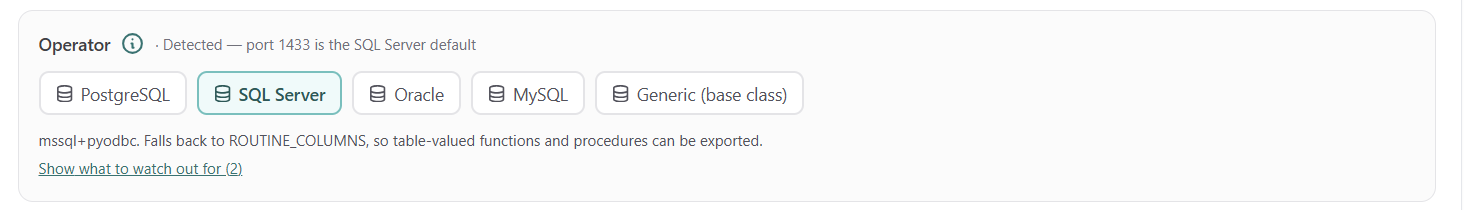
| DB | PostgreSQL, SQL Server, Oracle, MySQL samt en generisk basklass |
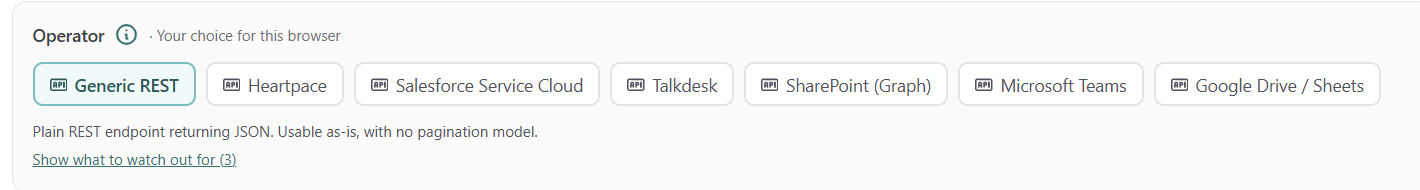
| API | Generic REST, Heartpace, Salesforce Service Cloud, Talkdesk, SharePoint (Graph), Microsoft Teams, Google Drive / Sheets |
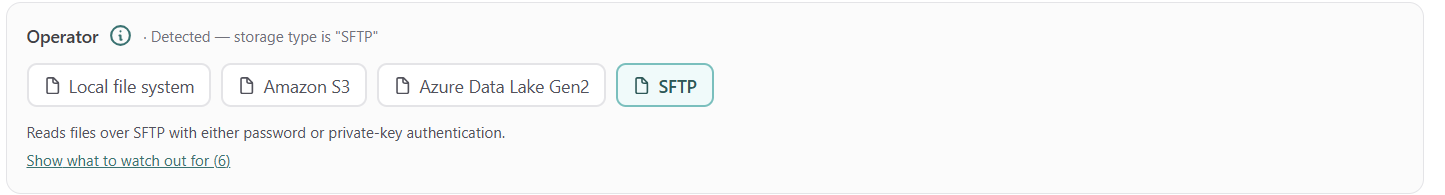
| FILE | Lokalt filsystem, Amazon S3, Azure Data Lake Gen2, SFTP |
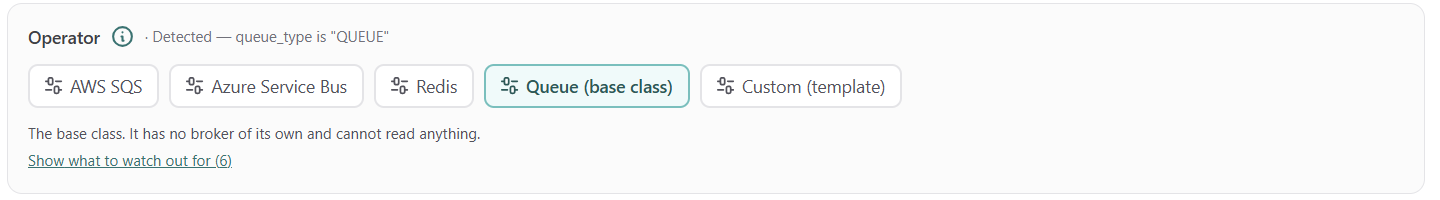
| CUSTOM | AWS SQS, Azure Service Bus, Redis samt en custom-mall |
Var valet lagras. Bara två anslutningstyper kan spara sin operator:
| Typ | Lagras i | Vad som gäller |
|---|---|---|
| FILE | fältet StorageType | den sparade anslutningen |
| CUSTOM (köer) | anslutningsegenskapen queue_type | den sparade anslutningen |
| DB | ingenstans — den ligger i agentens settings.yaml | detekteras från porten, kan överstyras per webbläsare |
| API | ingenstans — som ovan | detekteras från API-URL:en, kan överstyras per webbläsare |
För DB och API berättar väljaren hur den kom fram till sitt svar — detekterat från porten eller URL:en, eller ihågkommet från ett tidigare val i den här webbläsaren — i stället för att presentera en gissning som fakta. Valet formar bara formuläret; det skickas inte vidare någonstans.
Ett fåtal operatorer som skrivits för en enskild kunds källa erbjuds inte i väljaren, men ett system som redan är kopplat till en av dem känns fortfarande igen och får rätt formulär.
Databasoperatorer
API-operatorer
Filoperatorer
Custom-operatorer
Konfigurationsmallar
- Fill empty fields skriver bara där formuläret är tomt, så en mall kan aldrig skriva över något du själv har fyllt i.
- Reset to these values är en separat åtgärd för fallet "börja om från standardvärdena".
- En mall innehåller aldrig ett lösenord, en hemlighet eller en nyckel, och hittar aldrig på ett värde den inte kan känna till. Sådant hamnar i stället på checklistan över vad som återstår.
Det mesta som en ny anslutning behöver är identiskt för alla kunder till en given källa: porten, avgränsarna, grant-typen, kontrollheadrarna, scope. När du väljer operator erbjuds en eller flera mallar som fyller i detta och sedan listar vad de medvetet lämnat till dig, med en notering om var varje värde finns.
Det finns mallar för PostgreSQL, SQL Server, Oracle och MySQL; för OAuth 2.0 client credentials, OAuth med klientcertifikat och statiska bearer-tokens på den generiska REST-operatorn; för Talkdesk, Salesforce (password- och client-credentials-grant), SharePoint och Teams via Graph; samt för S3, SFTP (lösenord och privat nyckel), Azure Data Lake Gen2 och det lokala filsystemet.
Autentiseringsuppgifter — läs detta innan du sparar
- en sparad uppgift kommer tillbaka krypterad, och originalet går inte att läsa ut;
- att posta tillbaka det krypterade värdet skulle kryptera det en andra gång;
- anslutningen slutar då fungera vid nästa export, utan att UI:t visar varför — värdet ser oförändrat ut eftersom det är oförändrat, bara inslaget ett lager djupare än vad körningen förväntar sig.
API:et krypterar varje värde det tar emot. Allt annat följer av det:
En sparad uppgift återanvänds därför aldrig. Att spara en anslutning innebär att ange den riktiga uppgiften på nytt, och det du anger blir det som lagras. Det gäller lösenord för databaser och lagring, och krypterade värden inne i anslutningsegenskaperna — en client_secret för OAuth rensas till exempel när anslutningen laddas, och formuläret talar om vilka värden som rensades.
Förhandsgranskningen Show JSON innehåller alltid lösenordsnyckeln så att payloaden går att posta, men fyller den aldrig med det lagrade värdet. En nedladdad förhandsgranskning innehåller en skarp autentiseringsuppgift så snart en har skrivits in — behandla den som en hemlighet, inte som en konfigurationsfil.
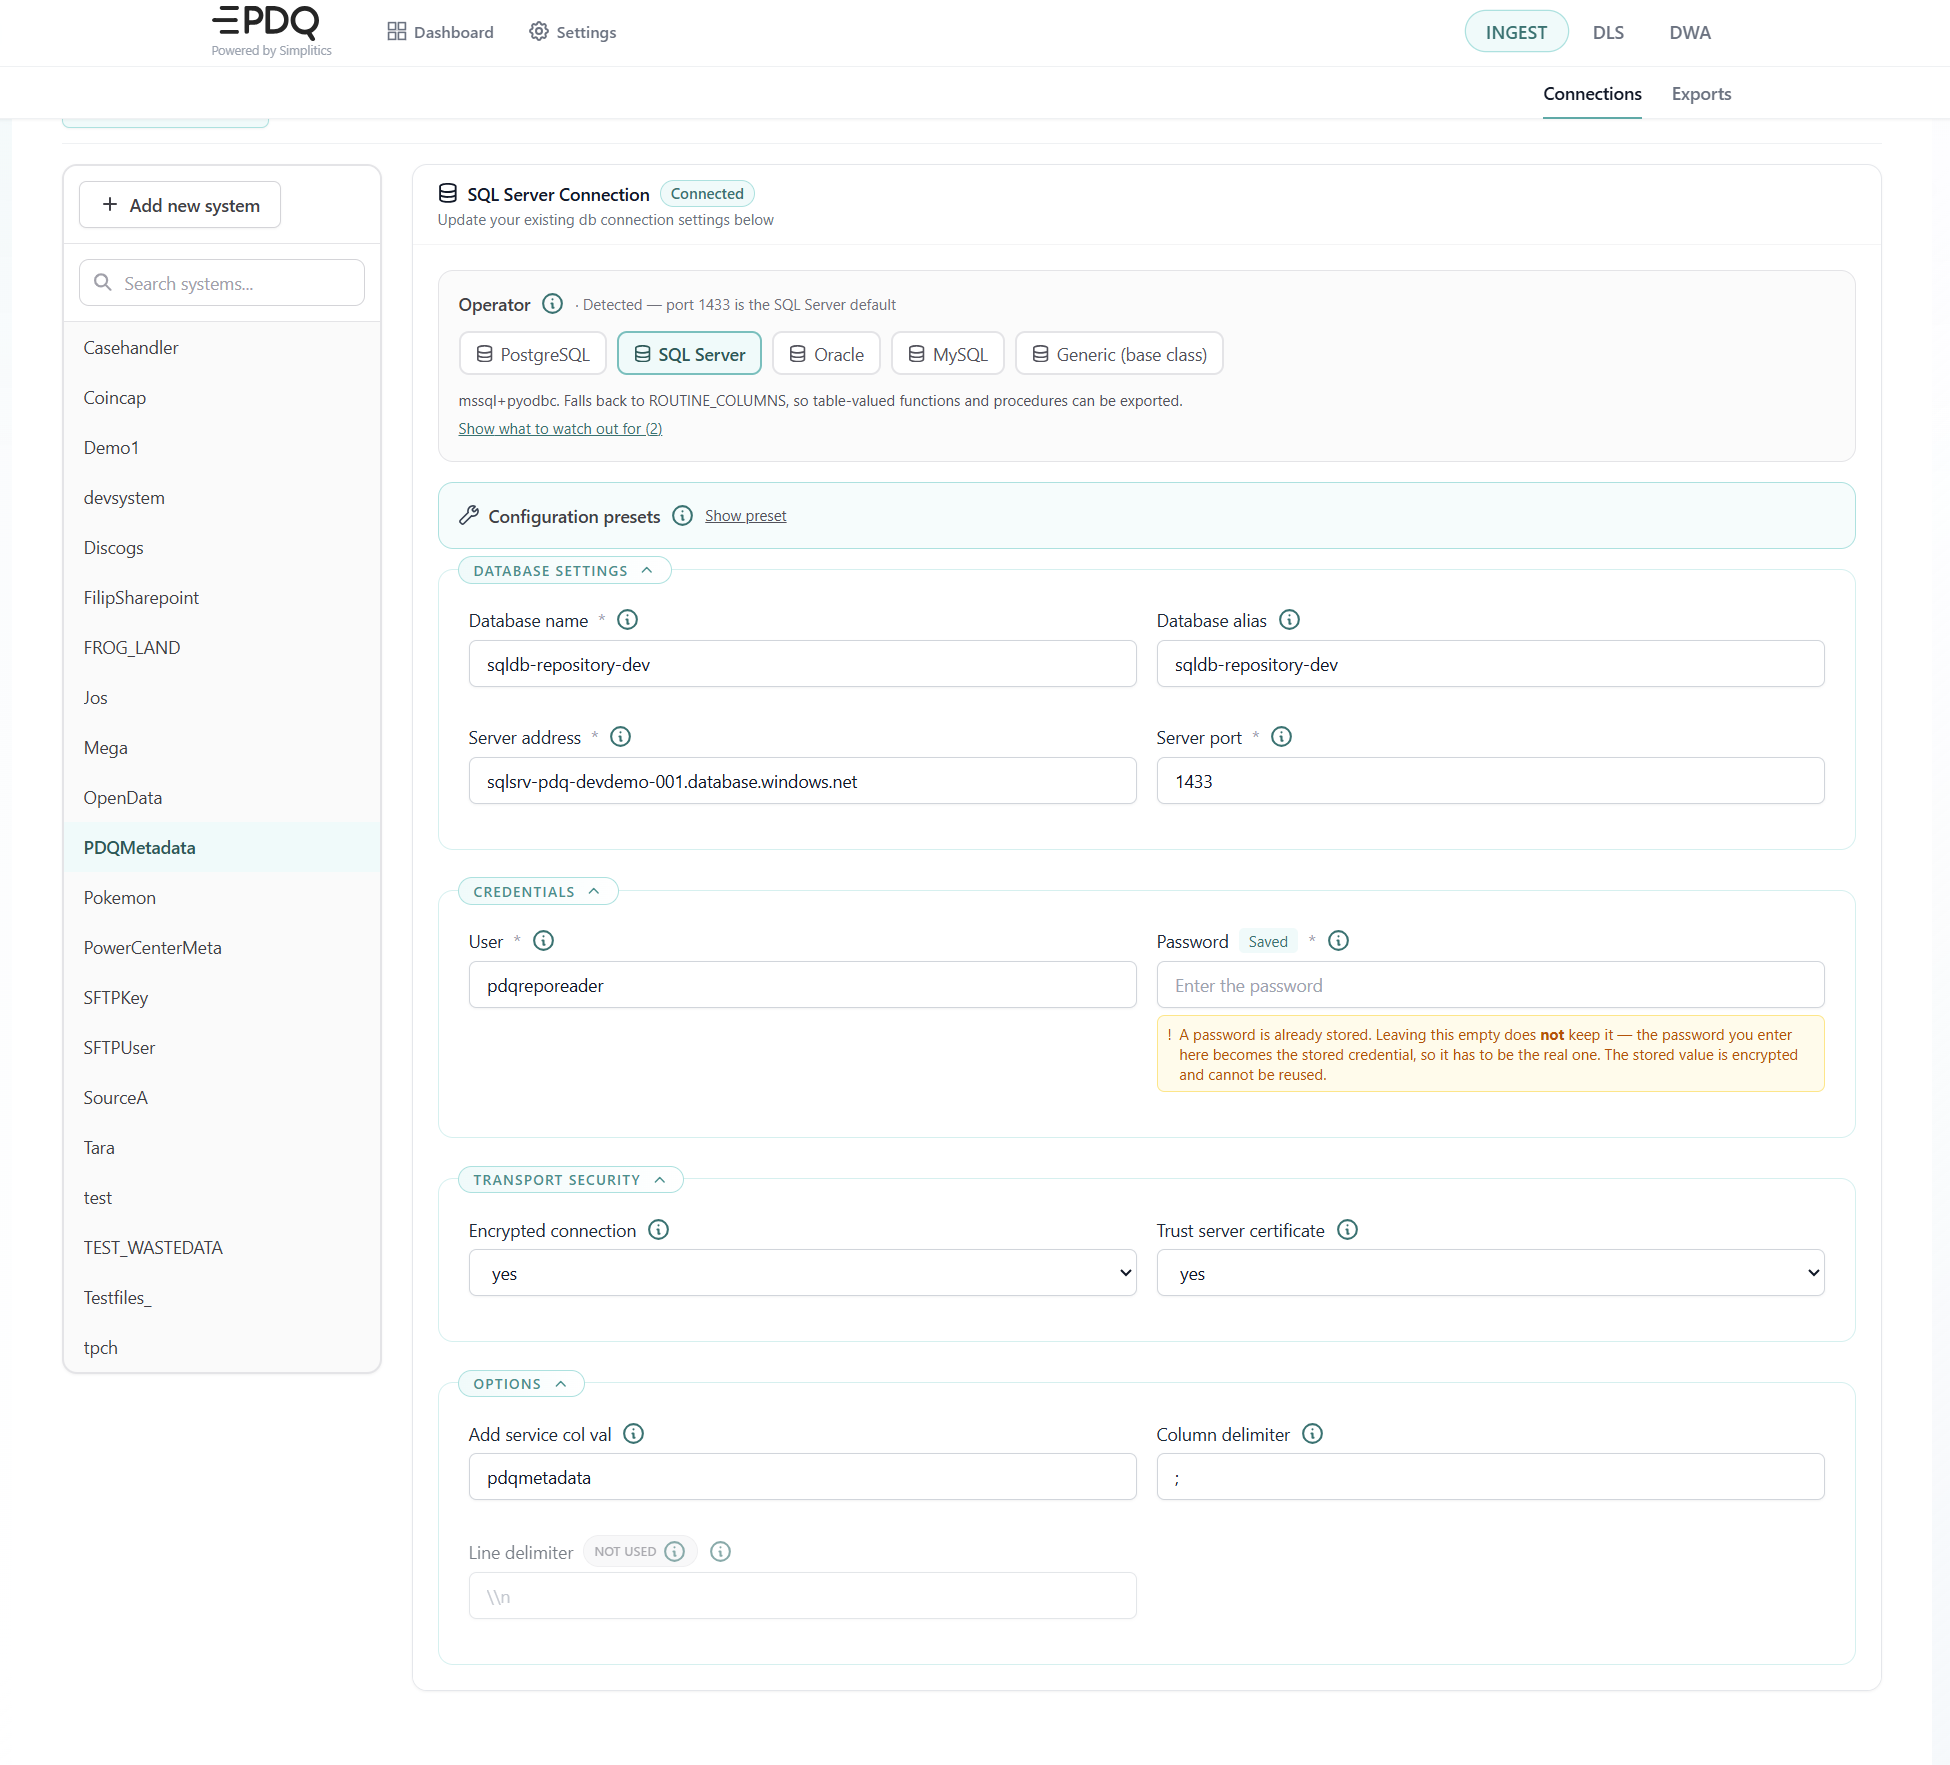
Databasanslutningsdetaljer
Databasnamn (DBNm): Namnet på databasen som ska anslutas. Obligatoriskt. För Oracle är detta service name, inte ett schema — det skickas som service_name.
Databasalias (DBAlias): Endast informativt. Det används inte för att nå servern.
Serveradress (DBServerAddr): Värdnamn eller IP till databasservern. Obligatoriskt.
Serverport (DBServerPort): Porten servern lyssnar på. Obligatoriskt. Formuläret förifyller operatorns standard: 5432 för PostgreSQL, 1433 för SQL Server, 1521 för Oracle, 3306 för MySQL. Det är också värdet som används för att detektera vilken databasoperator anslutningen kör.
Användare (DBUsr): Användarnamnet som används för autentisering. Obligatoriskt.
Lösenord (DBUsrPwd): Lösenordet för den användaren. Obligatoriskt och aldrig förifyllt — se Autentiseringsuppgifter ovan.
Krypterad anslutning (DBEncryptedConnection): yes begär en krypterad anslutning till servern.
Lita på serverns certifikat (DBTrustCertificate): yes accepterar serverns certifikat utan att validera det — vad en intern server med ett självsignerat certifikat behöver. På SQL Server blir detta TrustServerCertificate i anslutnings-URL:en.
API-anslutningsdetaljer
- OAuth 2.0 — postar anslutningsegenskaperna till token-URL:en och bygger
Authorization-headern från svaret. - Token — gör inget nätverksanrop och använder anslutningsegenskapen
bearer_tokendirekt. - Basic — beter sig som OAuth när en token-URL är satt, och faller tillbaka på bearer-token när den inte är det.
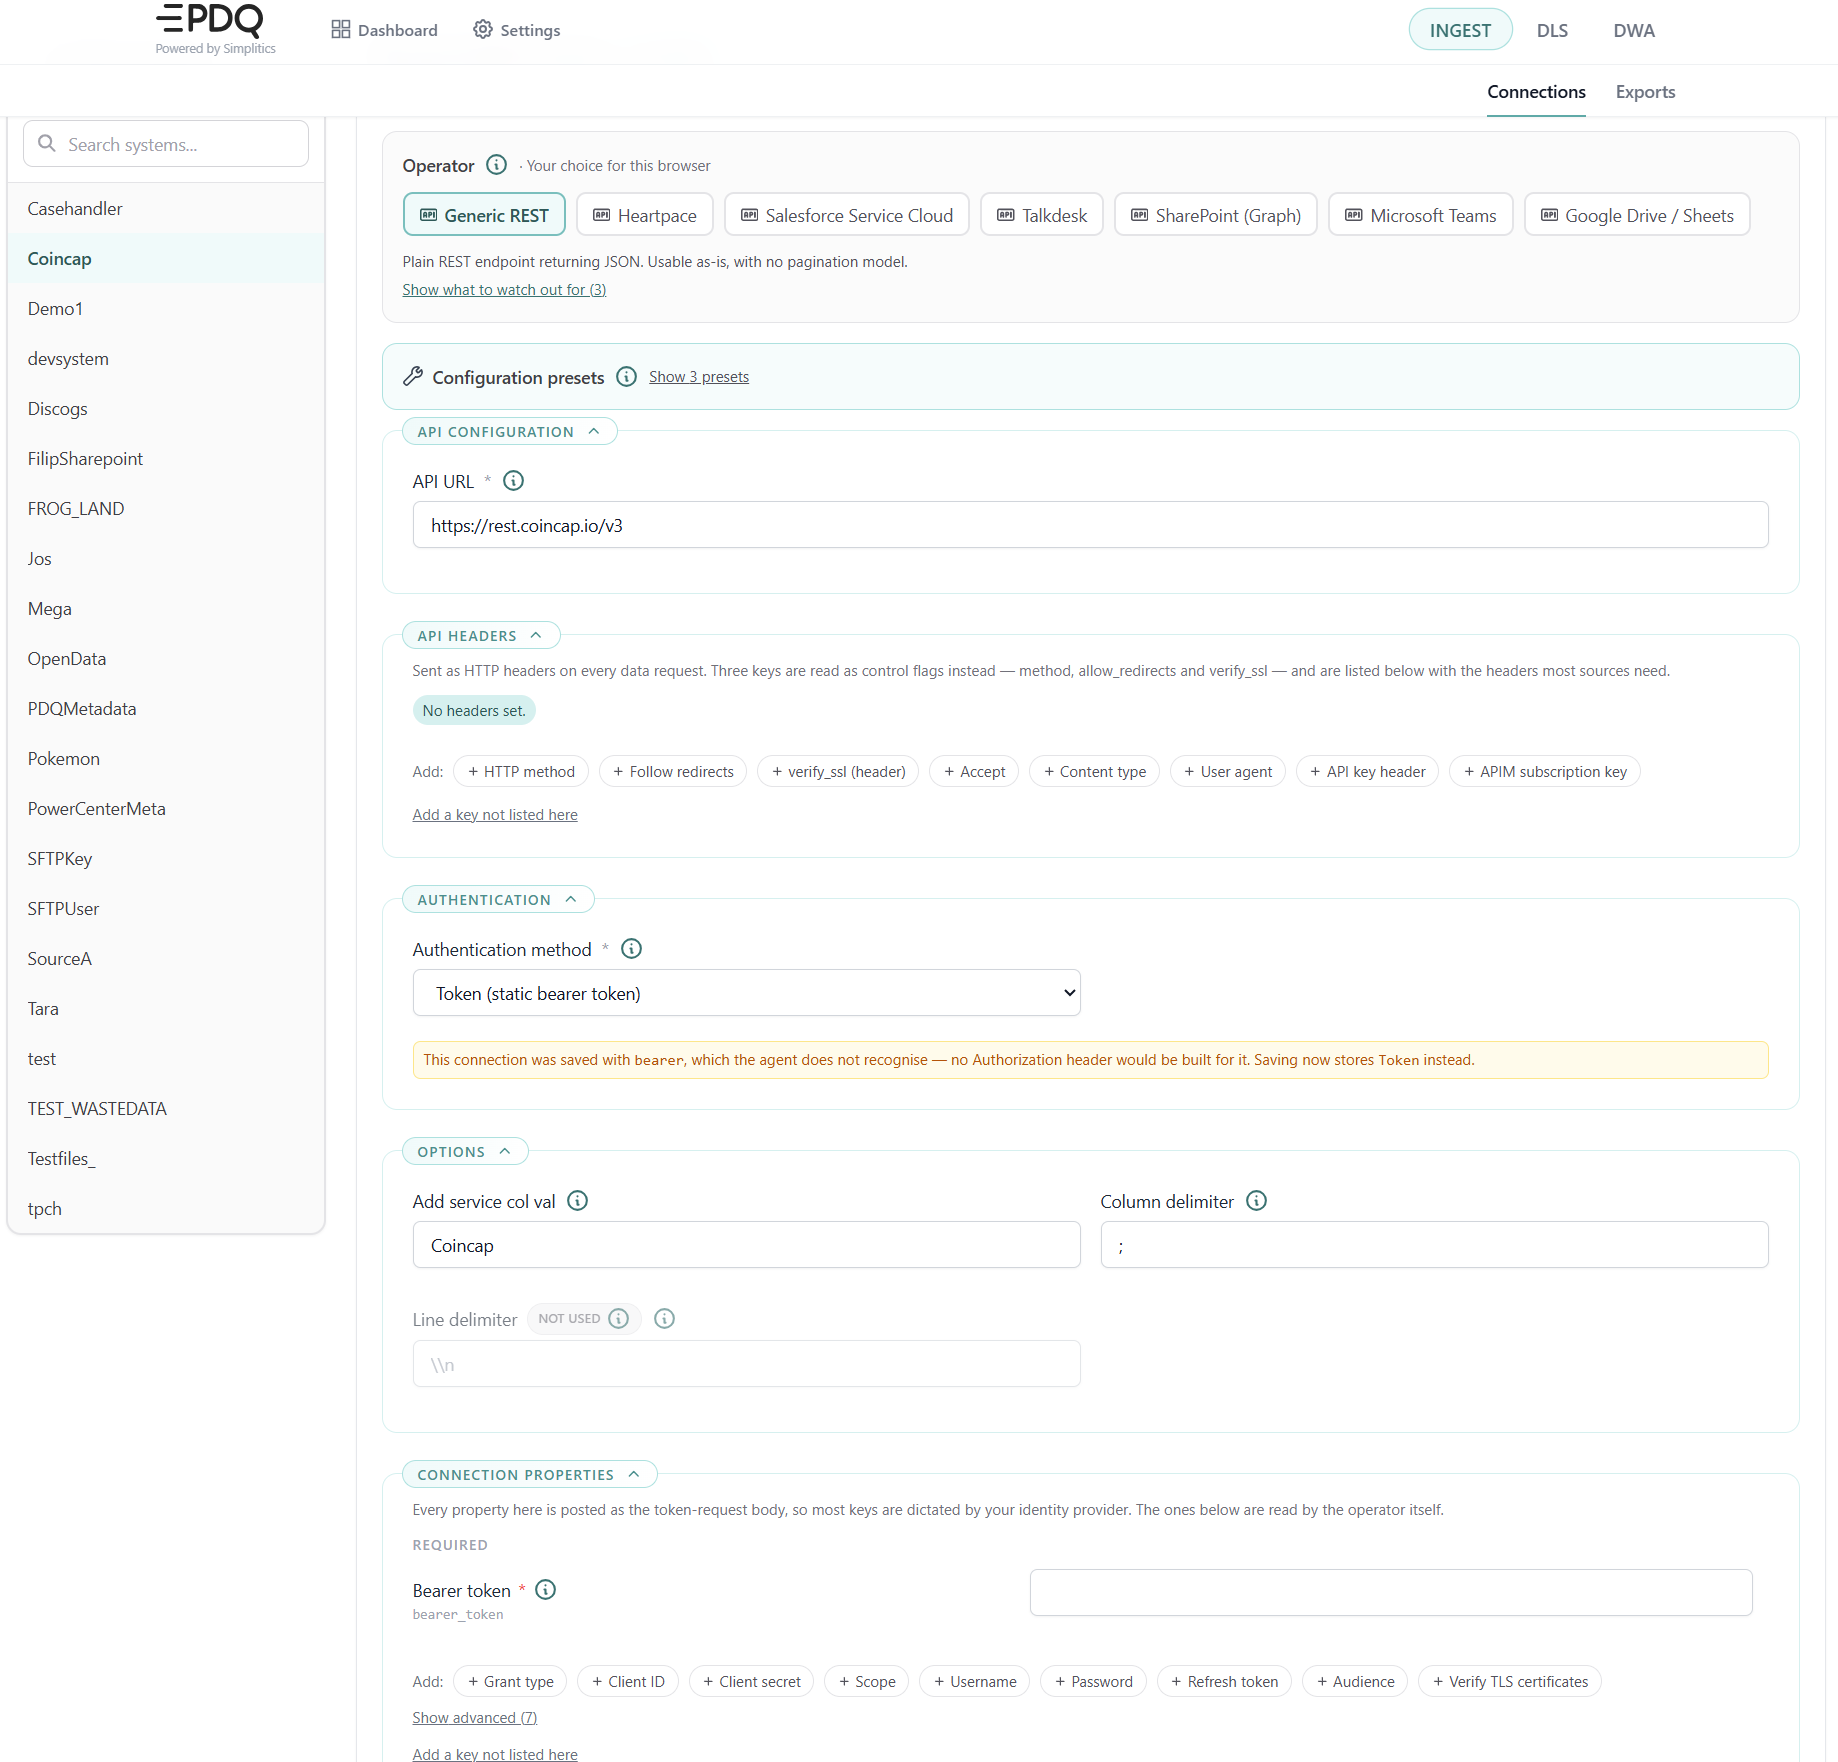
API-URL (APIUrl): Bas-URL:en. Varje exportdefinitions API-sökväg läggs till efter den. Obligatoriskt.
Autentiseringsmetod (APIAuthMethod): Avgör allt annat. Värdena som agenten jämför mot är:
Anslutningar som sparats av en äldre version av UI:t kan bära värden med små bokstäver (oauth, bearer, apikey, none) som agenten inte känner igen — ingen Authorization-header hade byggts för dem. Formuläret flaggar detta och sparar den nuvarande stavningen när du sparar.
Att välja OAuth 2.0 skriver in de egenskaper som konfigurationen kräver i egenskapslistan, så att formuläret och den sparade payloaden är överens.
Token-URL (APITokenUrl): Endpointen som anslutningsegenskaperna postas till i utbyte mot en access token. Obligatoriskt för OAuth 2.0; valfritt för Basic, där ett tomt värde innebär att en statisk bearer-token används.
API-headrar (APIHeader): Skickas som HTTP-headrar vid varje dataförfrågan, med tre undantag som läses som kontrollflaggor:
| Nyckel | Effekt |
|---|---|
method | post skickar filtervillkoren som en JSON-body; allt annat skickar en GET med query-parametrar. |
allow_redirects | Ta bort nyckeln för att sluta följa omdirigeringar. Den testas på sanningsvärde, så strängen false aktiverar dem fortfarande — ta bort raden i stället. |
verify_ssl | Tas bort enbart från token-förfrågan. Den skickas fortfarande som en bokstavlig HTTP-header vid dataförfrågningar; använd anslutningsegenskapen verify_ssl i stället. |
De headrar de flesta källor behöver erbjuds i lägg-till-menyn — Accept, Content-Type, User-Agent och X-API-Key för API-nyckelautentisering. Headernamn är inte standardiserade, så kontrollera leverantörens egen stavning.
Anslutningsegenskaper (APIConnectionProperties): Postas som token-förfrågans body, så de flesta nycklar kommer från din identitetsleverantör snarare än från agenten:
| Nyckel | Används för |
|---|---|
grant_type | Vilket OAuth-flöde som används. client_credentials flyttar klient-id och hemlighet till en HTTP Basic-header; password behåller allt i bodyn. Postas ordagrant, så ett leverantörsspecifikt grant kan skrivas in. |
client_id / client_secret | Uppgiftsparet, för client-credentials- och password-grant. |
username / password | Resursägarens uppgifter, för password-grant. |
refresh_token | Den långlivade token, för refresh-token-grant. Fungerar bara där leverantören ger ut en icke-roterande token. |
scope | Vad token får nå. Krävs av vissa leverantörer, valfritt för andra. |
audience | Namnger API:et som token gäller. Auth0 kräver det; utan det kommer token tillbaka ogenomskinlig och källan avvisar den. |
assertion | Den signerade JWT:n, för JWT-bearer-grant. |
client_assertion / client_assertion_type | En signerad JWT som autentiserar klienten i stället för en hemlighet — Entra ID med certifikat till exempel. |
resource | Krävs av vissa äldre identitetsleverantörer. |
token_auth_method | Var klientuppgifterna placeras, för leverantörer som erbjuder ett val. |
bearer_token | Den statiska token, för autentiseringsmetoden Token. |
verify_ssl | Sätt false för att stänga av TLS-verifiering vid varje förfrågan. Exponerar anslutningen för avlyssning — endast mot ett känt trasigt internt certifikat. |
cert_file / key_file | Klientcertifikat och nyckel inne i containern, för ömsesidig TLS. |
Vilka av dessa som är obligatoriska följer autentiseringsmetoden och grant-typen, inte operatorn — en client secret behövs för ett client-credentials-utbyte och är meningslös för en statisk bearer-token. Redigeraren grupperar de obligatoriska först.
Källor bakom en gateway. Om källan nås via en gateway (till exempel Azure API Management) upphör leverantörens egen vägledning att gälla: scope, grant-typ och autentiseringsuppgifter blir vad gatewayen förväntar sig. Formuläret märker detta på token-URL:en, drar tillbaka de leverantörsspecifika förslagen och säger varför. Azure API Management behöver dessutom oftast en Ocp-Apim-Subscription-Key-header, som erbjuds på alla API-operatorer.
Filanslutningsdetaljer
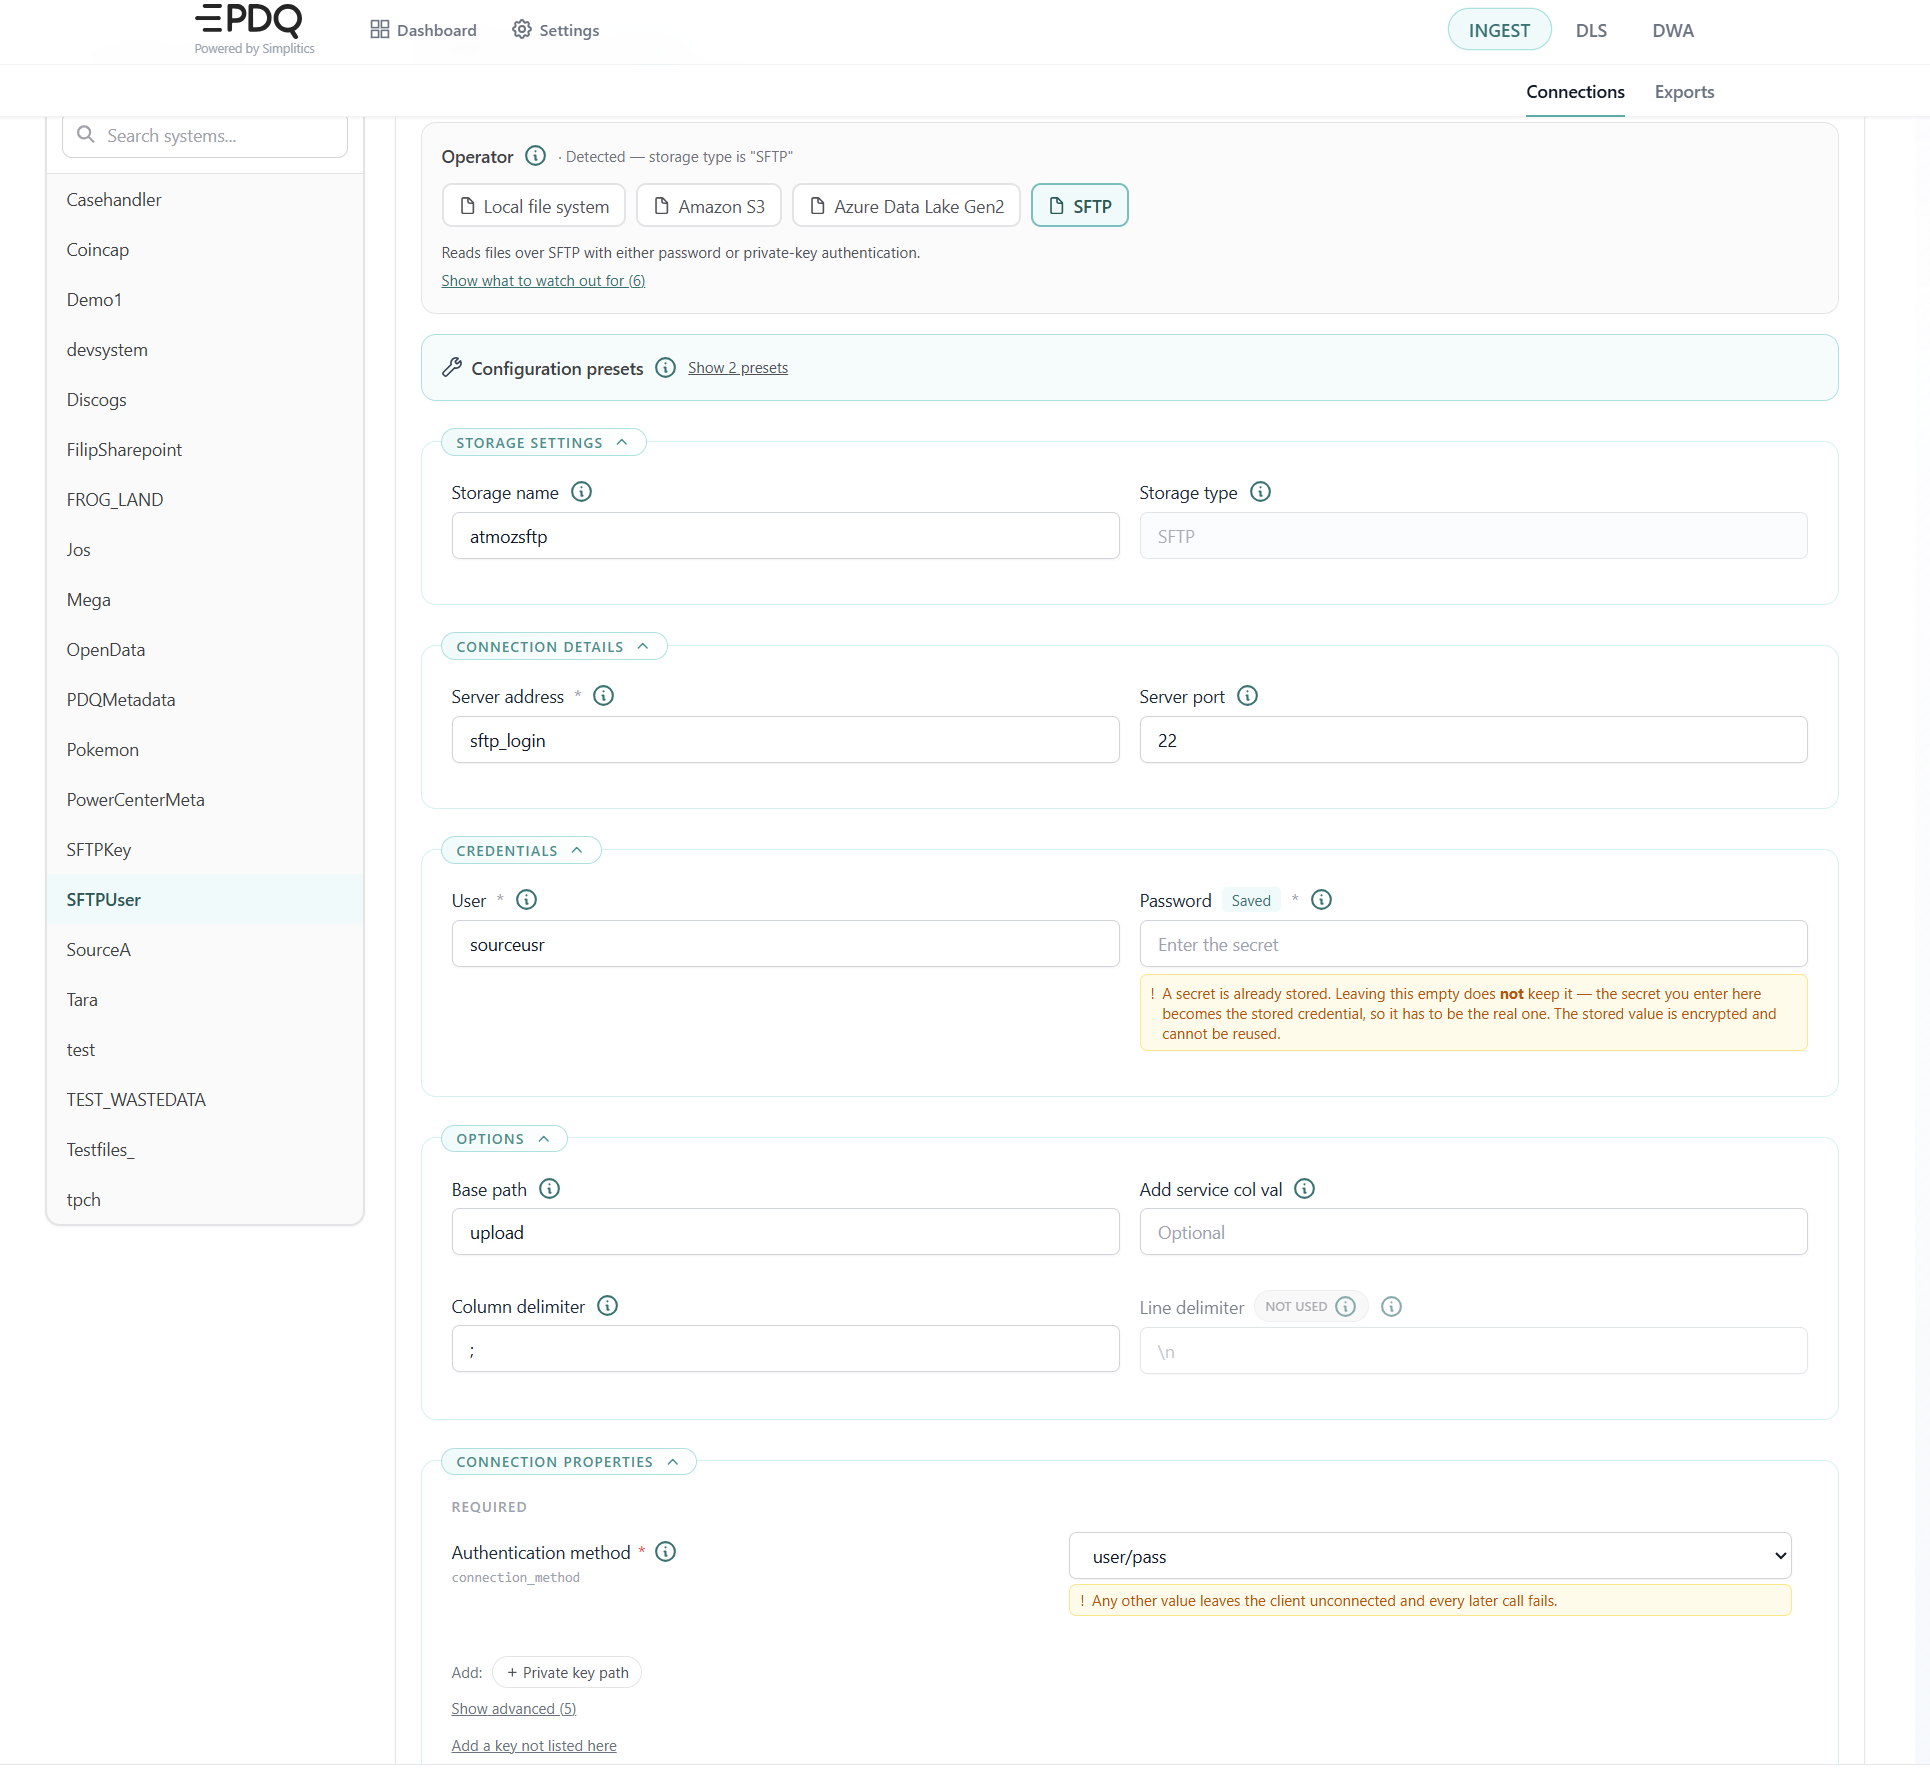
Storage name (StorageName): Bucket-namnet för S3, lagringskontot för Azure Data Lake Gen2. Informativt för SFTP och en lokal sökväg.
Region (StorageRegion): AWS-regionen. Obligatoriskt för S3; används inte i övrigt — ADLS-endpointen härleds från kontonamnet.
Storage type (StorageType): Skrivskyddat. Det bär den valda operatorn och är det värde både körningen och den här sidan läser.
Serveradress / Serverport (StorageServerAddr, StorageServerPort): Endast SFTP; porten är 22 som standard. S3 och ADLS adresseras med region, bucket och kontonamn i stället för med värdnamn.
Användare / Lösenord (StorageUsr, StorageUsrPwd): Betydelsen beror på operatorn — access key id och secret access key för S3, inloggningsanvändare och lösenord (eller nyckelns lösenfras) för SFTP, samt kontonyckel eller SAS-uppgift för ADLS. För ADLS måste användarfältet vara ifyllt för att klienten alls ska byggas, men själva värdet används aldrig.
Base path (StorageBasePath): Rotkatalogen för en lokal sökväg, nyckelprefixet för S3, Gen2-filsystemets (containerns) namn för ADLS. Den slås ihop med exportdefinitionens filsökväg.
Anslutningsegenskaper (StorageConnectionProperties): SFTP kräver connection_method (user/pass eller private_ssh_id) och läser private_ssh_id_path. Alla filoperatorer exponerar dessutom prestandainställningar under Show advanced — minne per hämtningsbatch, skrivbatchstorlek, gzip-nivå och nedladdningsblockets storlek.
Custom- och köanslutningsdetaljer
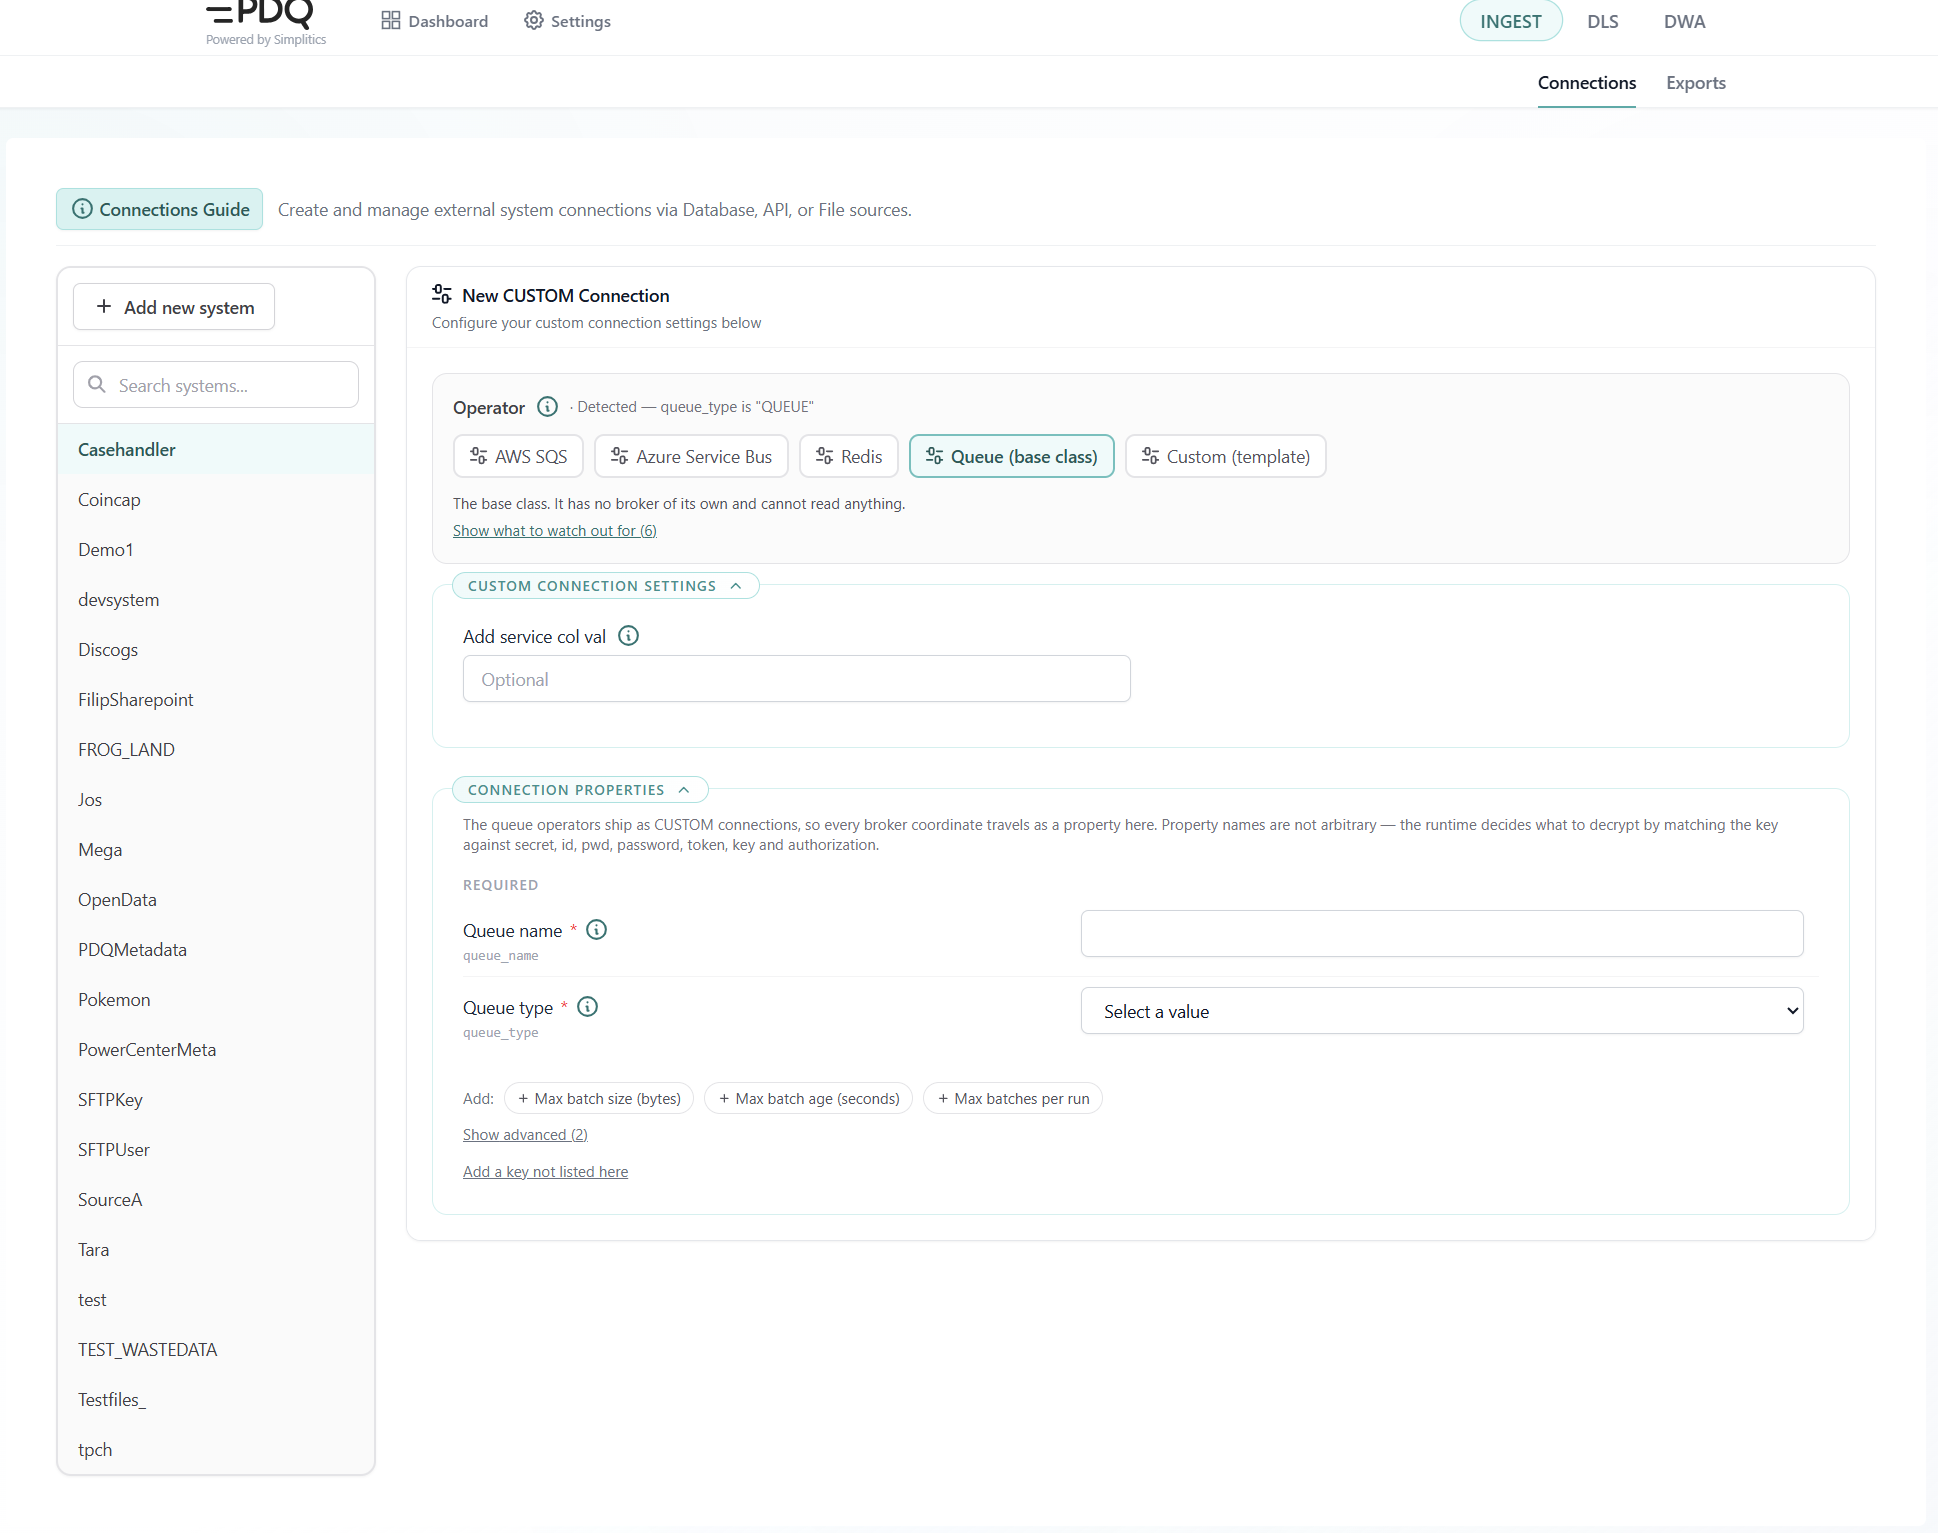
Köanslutningar levereras som CUSTOM, så varje koordinat färdas som en anslutningsegenskap i formen nyckel=värde.
Queue type (queue_type): SQS, SERVICEBUS eller REDIS. Det är så sidan vet vilken broker du konfigurerar. Obligatoriskt.
Queue name (queue_name): SQS löser upp kö-URL:en från detta vid anslutning; för Redis är det stream- eller listnyckeln. Obligatoriskt.
Brokeruppgifter är namngivna för att matcha körningens dekrypteringsregel, som fungerar på delsträngsmatchning av nyckeln — access_id, access_key och connection_token dekrypteras, medan varje inställningsparameter medvetet är namngiven för att undvika regeln. SQS behöver region, access_id och access_key; Service Bus behöver connection_token och, för ett topic, topic_name och subscription_name; Redis tar antingen en connection_token-URL eller host/port/access_id/access_key/db, plus sina consumer group-inställningar.
Batchgränser — max_batch_bytes (30 MB), max_batch_seconds (15 minuter), max_batches_per_run (0 = obegränsat), receive_batch_size och receive_wait_seconds — avgör när en batchfil stängs. De tre första kan överstyras per export.
Inställningar som delas av alla anslutningstyper
Add service col val (AddServiceColVal): När värdet är satt får varje exporterad post en __service-kolumn med det värdet.
Column delimiter (ColumnDelimiter): Fältavgränsare som används när CDC skriver CSV-utdata. Ignoreras för JSON.
Line delimiter (LineDelimiter): Läses men respekteras inte av de flesta operatorer — de tvingar \n oavsett värde. Formuläret märker fältet som Not used där så är fallet.
Att spara
Show JSON öppnar exakt den payload som kommer att postas, med en nedladdningsknapp. Add connection / Update connection sparar den. Obligatoriska fält, och de egenskaper som den valda operatorn inte kan köra utan, valideras innan förfrågan skickas, och eventuella fel rapporteras intill knappen.
Källexport-konfiguration
Sidan INGEST → Exports (/sourceexports) konfigurerar vad varje export läser och var den landar. Källexport är processen att läsa en specifik tabell, endpoint, katalog eller kö och skriva resultatet till landningszonen. En fil skapas där med ett namn byggt av fälten Output file name, suffix och format.
Välj ett system i sidopanelen. Om det saknar anslutning säger sidan det och länkar till Connections-sidan. Exportformuläret formas av samma operatorregister som anslutningsformuläret, så ett fält som operatorn ignorerar visas med märket Not used i stället för att tas bort.
Lägga till eller redigera konfiguration
För att redigera en befintlig konfiguration väljer du den i listan Edit configuration. När du gjort dina ändringar klickar du på Update configuration.
För att lägga till en ny konfiguration lämnar du listan tom — eller klickar på Reset/New för att tömma formuläret — fyller i den och klickar på Add configuration.
Efter en lyckad sparning erbjuder sidan att skapa en matchande källfil i DLS, förifylld från exporten du just definierat.
Inställningar som delas av alla exporttyper
Change Data Capture (CDC) (enableCDC): Spårar förändringar i källdatan. På (1) exporterar bara nya, borttagna eller ändrade poster sedan förra körningen; av (0) exporterar allt varje gång. CDC jämför varje körning mot en baslinje som agenten håller lokalt, i filen <alias>_latestversion.txt inuti sin egen container. Baslinjen överlever en omstart — det är vad filen finns för. Den överlever inte att containern förstörs eller tas bort: nästa körning exporterar då allt en gång och bygger upp en ny baslinje. Köexporter går förbi CDC helt — låt den vara av där.
Output file name / Alias (alias): Filnamnsstammen för den exporterade datan, och namnet som nedströmsprocesser identifierar den med. Obligatoriskt.
Output format (outputFormat): json, csv eller binary. För filsystemskällor konverterar json och csv filerna med DuckDB, medan binary laddar upp dem orörda och hoppar över CDC. De vanliga API-operatorerna skriver alltid radavgränsad JSON oavsett inställning, och formuläret säger det.
Output file suffix (suffix): Läggs till i filnamnet. Antingen en bokstavlig sträng eller ett dynamiskt tidsvärde — se Dynamiska tidsvärden nedan. Obligatoriskt.
Time token format (dateTimeFormat): Den exportövergripande formateringen som används av varje tidsvärde som inte bär ett eget AS-segment. Standard är TIMESTAMP, eller DATETIME för databasoperatorer, vilket passar SQL-literaler. Varje värde som inte är ett av de namngivna formaten tolkas som ett bokstavligt mönster byggt av [YYYY] [YY] [MM] [DD] [HH] [MI] [SS].
Stop at row (stopAtRow): Gräns för tidigt avbrott; -1 är obegränsat. Vad som räknas skiljer sig per operator — rader för en databas, poster för ett API, hela filer för en binär filexport, meddelanden över hela körningen för en kö.
Fältval (inclColumns / exclColumns): Include-listan är en tillåtelselista (* behåller allt) och exclude-listan tillämpas efter den, så nekande vinner. På databasexporter fogas include-listan rakt in i SELECT-satsen och stödjer alias och uttryck; exclude-listan tar där inte bort kolumner — den hindrar bara typkonvertering, så ta bort kolumner ur include-listan i stället. Formuläret markerar detta.
Substitutions (substitutions): Härledda eller defaultade kolumner som tillämpas under exporten. Användbart för nullersättning och för att maskera känsliga data.
Schema: Schedule cycle (scheduleCycle) är never, minute, hourly, daily eller monthly — never stänger av exporten utan att ta bort den, och API-exporter erbjuder never, hourly och daily. Intervall under 15 minuter rekommenderas inte. Schedule cycle interval (scheduleCycleInterval) är hur många sådana enheter det går mellan körningarna. Do not start before (scheduleDoNotStartBeforeTime) är den tidigaste tidpunkten på dygnet exporten får starta, som HH:MM:SS.
Dynamiska tidsvärden
- Hive är bara giltigt för sökvägar. Det producerar en katalogsökväg, inte en tidsstämpel, så det hör hemma i en filsökväg och ingen annanstans. Det kan inte användas som exportövergripande tidsformat.
HIVEochHIVE_PADDEDär inte utbytbara. Vilket som hittar din data beror på hur källan skrev sina partitioner —month=8ellermonth=08. Väljaren erbjuder båda sida vid sida i stället för att gömma paddningen bakom en växlare.- Ett värde som formuläret inte känner igen behålls ordagrant och redigeras som text, flaggat som okänt. Ingenting skrivs om i tysthet.
Exportdefinitioner kan bära värden som agenten löser upp vid körning i stället för fast text. De används för filnamnssuffixet, filsökvägen till en partitionerad källa, filnamn, API-förfrågningsparametrar, SQL-where-satser och ändarna på ett filurvalsfönster.
UI:t ber dig aldrig stava ett token: det frågar vilket ögonblick, hur långt bakåt och vilken form, och visar sedan det sammansatta värdet tillsammans med en läsbar tolkning av det.
Grammatik
[__<TIME>[_MINUS_<N>_<UNIT>][_AS_<FORMAT>]__]
<TIME> — vilket ögonblick
| Token | Betydelse |
|---|---|
EXECUTIONTIME | Nu, i agentens konfigurerade tidszon. Följer med fördröjningar och omförsök. |
SCHEDULEDTIME | Den tidslucka körningen tillhör. Samma värde hur sent körningen än startar, så ett omförsök läser samma fönster. |
LASTEXECUTION | Den föregående lyckade körningens schemalagda tid. 1900-01-01T00:00:00 vid första körningen, vilket läser allt. |
_MINUS_<N>_<UNIT> — hur långt bakåt. <UNIT> är en av SECONDS, MINUTES, HOURS, DAYS, WEEKS. Det finns inget _PLUS_: en export läser ett fönster som redan inträffat, så förskjutningen går bara bakåt.
_AS_<FORMAT> — vilken form värdet får
| Format | Återges som |
|---|---|
TIMESTAMP | 2026-08-12T14:30:45 — standard för API-, fil-, custom- och kökällor |
DATETIME | 2026-08-12 14:30:45 — standard för databaskällor; passar SQL-literaler |
DATE | 2026-08-12 |
DATECOMPACT | 20260812 |
TIME | 14:30:45 |
ISO | 2026-08-12T14:30:45+0200 — bär agentens UTC-offset |
EPOCH | 1786537845 — sekunder sedan 1970 |
EPOCHMS | 1786537845000 — millisekunder sedan 1970 |
HIVE | year=2026/month=8/day=13 — en partitionssökväg, inte en tidsstämpel |
HIVE_PADDED | year=2026/month=08/day=13 — samma sak, med tvåsiffrig månad och dag |
HIVE accepterar även granularitet och padding tillsammans, till exempel HIVE_DAY_PADDED.
Vilket format som används. Löses upp i denna ordning: _AS_-segmentet på värdet självt, sedan exportens Time token format, sedan källans egen standard. Ett värde utan _AS_ är alltså inte oformaterat — det ärver, och väljaren namnger formatet det kommer att ärva.
Regler värda att känna till
Äldre stavningar. Båda känns igen och fungerar fortsatt; formuläret flaggar dem och skriver den nuvarande stavningen om du redigerar värdet.
| Skrivet | Betyder |
|---|---|
[__LAST_N_DAYS__] | Samma sak som [__EXECUTIONTIME_MINUS_N_DAYS__]. En dokumenterad förkortning. |
[__LASTEXECUTION__] | Avsett som LASTEXECUTION. Skrevs av en äldre version av admin-UI:t; grammatiken listar inte det namnet, så exporter som bär det kan aldrig ha lösts upp. Värt att kontrollera. |
En annan sak: file timestamp format. [YYYY][MM][DD] i File timestamp format är inte ett dynamiskt värde. Det beskriver hur en tidsstämpel stavas inne i källans egna filnamn, så att agenten kan matcha dem. Den finaste delen som förekommer sätter dessutom sökgranulariteten — [HH] söker per timme, [DD] per dag, [MM] per månad, [YYYY] per år — och källan listas en gång per period, så ett dagligt format över ett år blir 365 listningsanrop.
Databasexporter
- Where clause (
whereClause): Infogas ordagrant, så den måste innehålla nyckelordetWHERE. Ett inkrementellt filter läggs till medAND. Tidstoken ersätts här. - SQL override (
sqlOverride): Ersätter den genererade frågan helt — användbart för underfrågor och joins när du inte kan skapa vyer eller procedurer i källan. Tidstoken ersätts fortfarande, men det inkrementella filtret läggs inte till, så bygg in det själv.
Database name (databaseName): Skrivskyddat. Hämtas från anslutningen.
From clause (fromClause): Tabellen, funktionen, vyn eller proceduren som SQL-frågan byggs mot, utom när sqlOverride används. Obligatoriskt, och namnet måste vara schemakvalificerat (dbo.Customers) — metadatauppslagningen delar på punkten, så ett namn utan punkt får körningen att misslyckas.
Included tables (inclTables): Ytterligare tabeller vars kolumnmetadata samlas in för typkonvertering. Standard är from-satsen.
SQL query: En växlare väljer mellan den genererade frågan och en fullständig override.
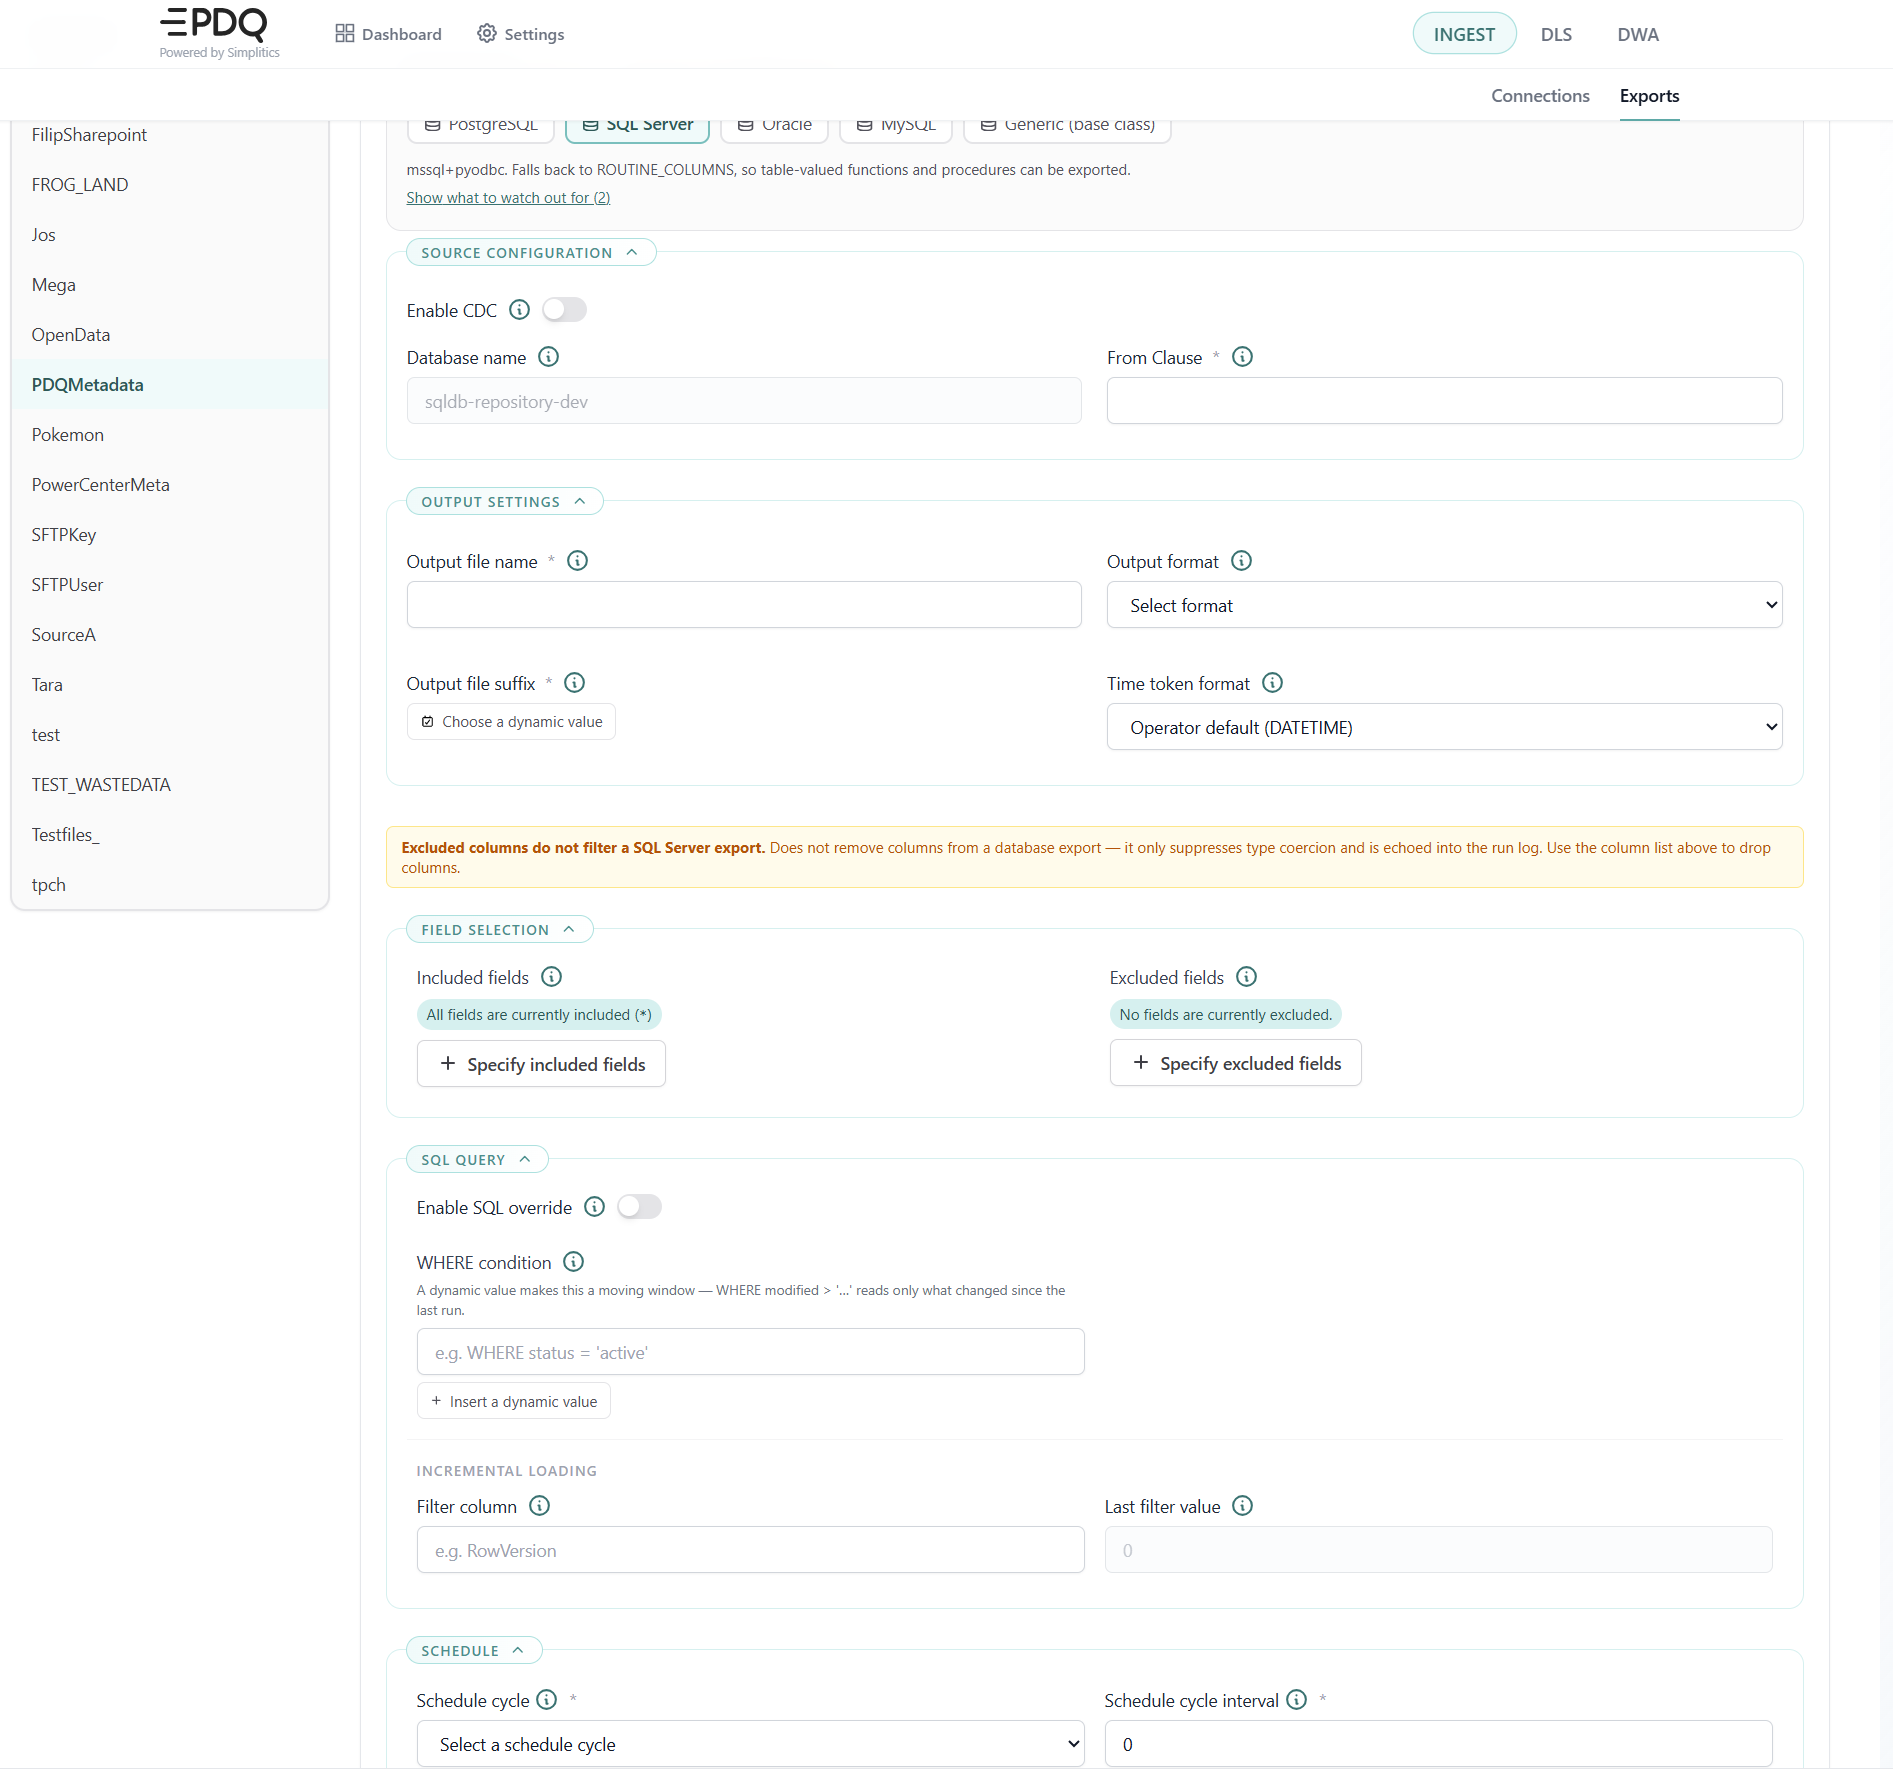
Filter column (filterColumn): Aktiverar inkrementell laddning. Jämförelsen är numerisk, så kolumnen måste vara ett stigande tal.
Last filter value (lastFilterValue): Vattenmärket från föregående körning, som postas tillbaka efter varje körning. 0 vid första körningen.
API-exporter
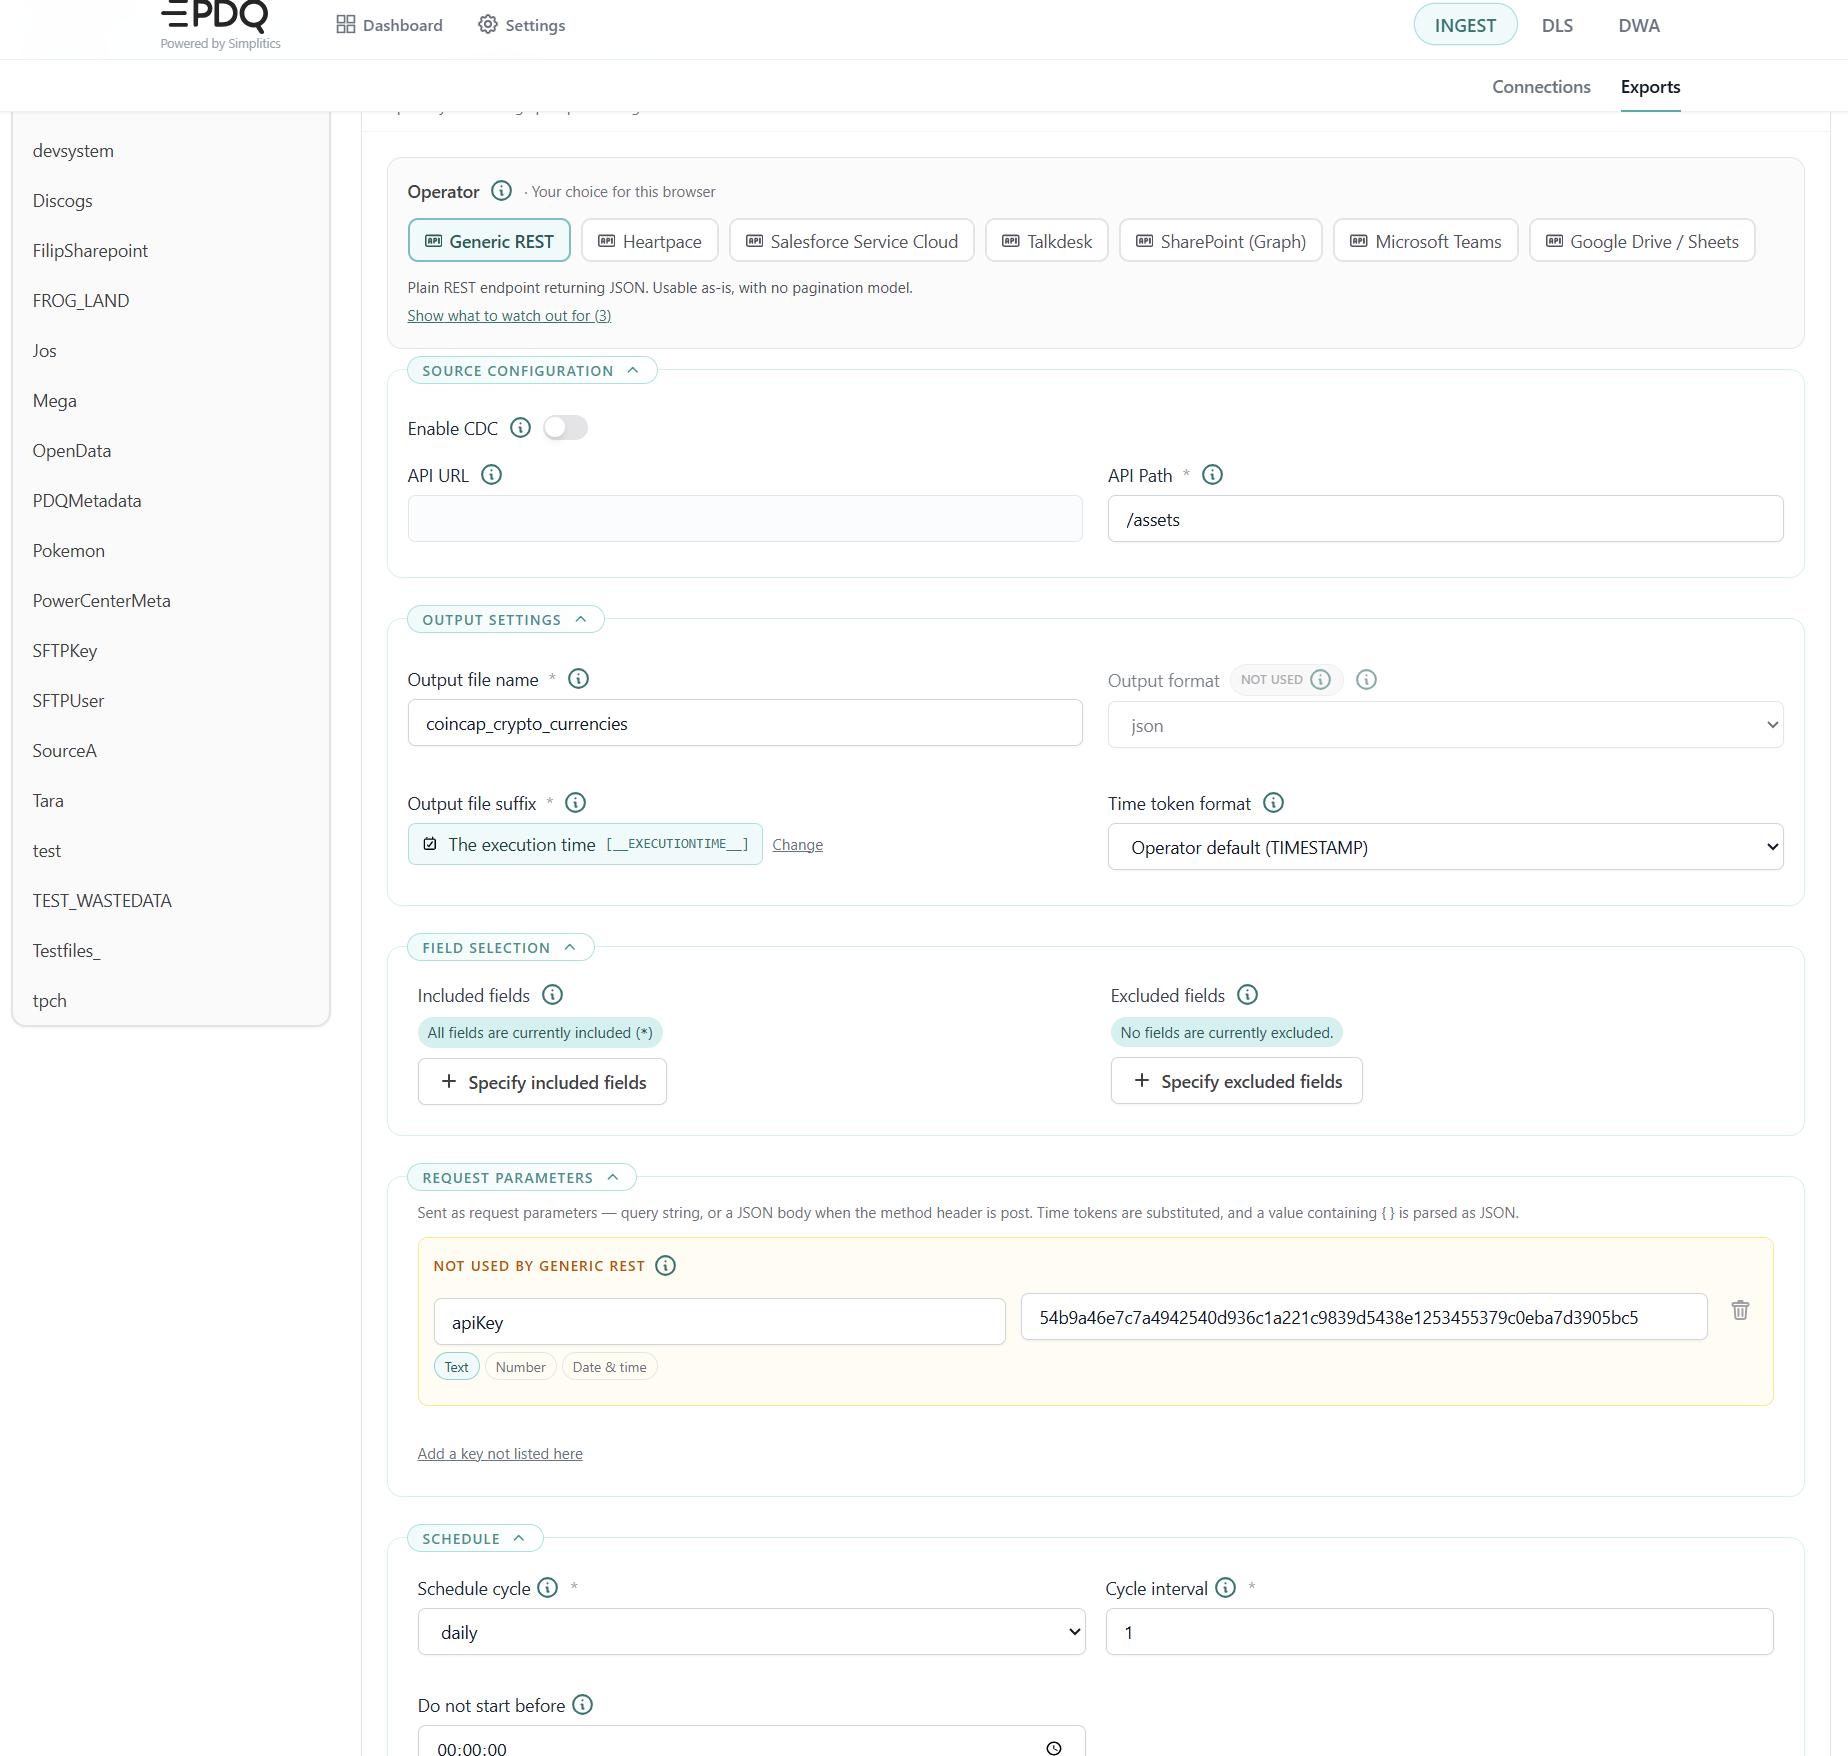
API URL (apiUrl): Skrivskyddat. Hämtas från anslutningen.
API path (apiPath): Sökvägen som läggs till efter anslutningens API-URL, till exempel /api/v1/data/export. Obligatoriskt.
Request parameters (filterCondition): Skickas som förfrågningsparametrar — en query-sträng, eller en JSON-body när headern method är post. Tidstoken ersätts, och ett värde som innehåller klammerparenteser tolkas som JSON.
Parametrar du definierar själv innehåller text, ett tal eller ett datum och en tid. Typen härleds från värdet och erbjuds som en växlare; den styr bara vilken kontroll du redigerar med. Datum och tid är där dynamiska värden hör hemma — ett rörligt fönster som följer schemat i stället för ett datum som måste redigeras för hand.
Filexporter
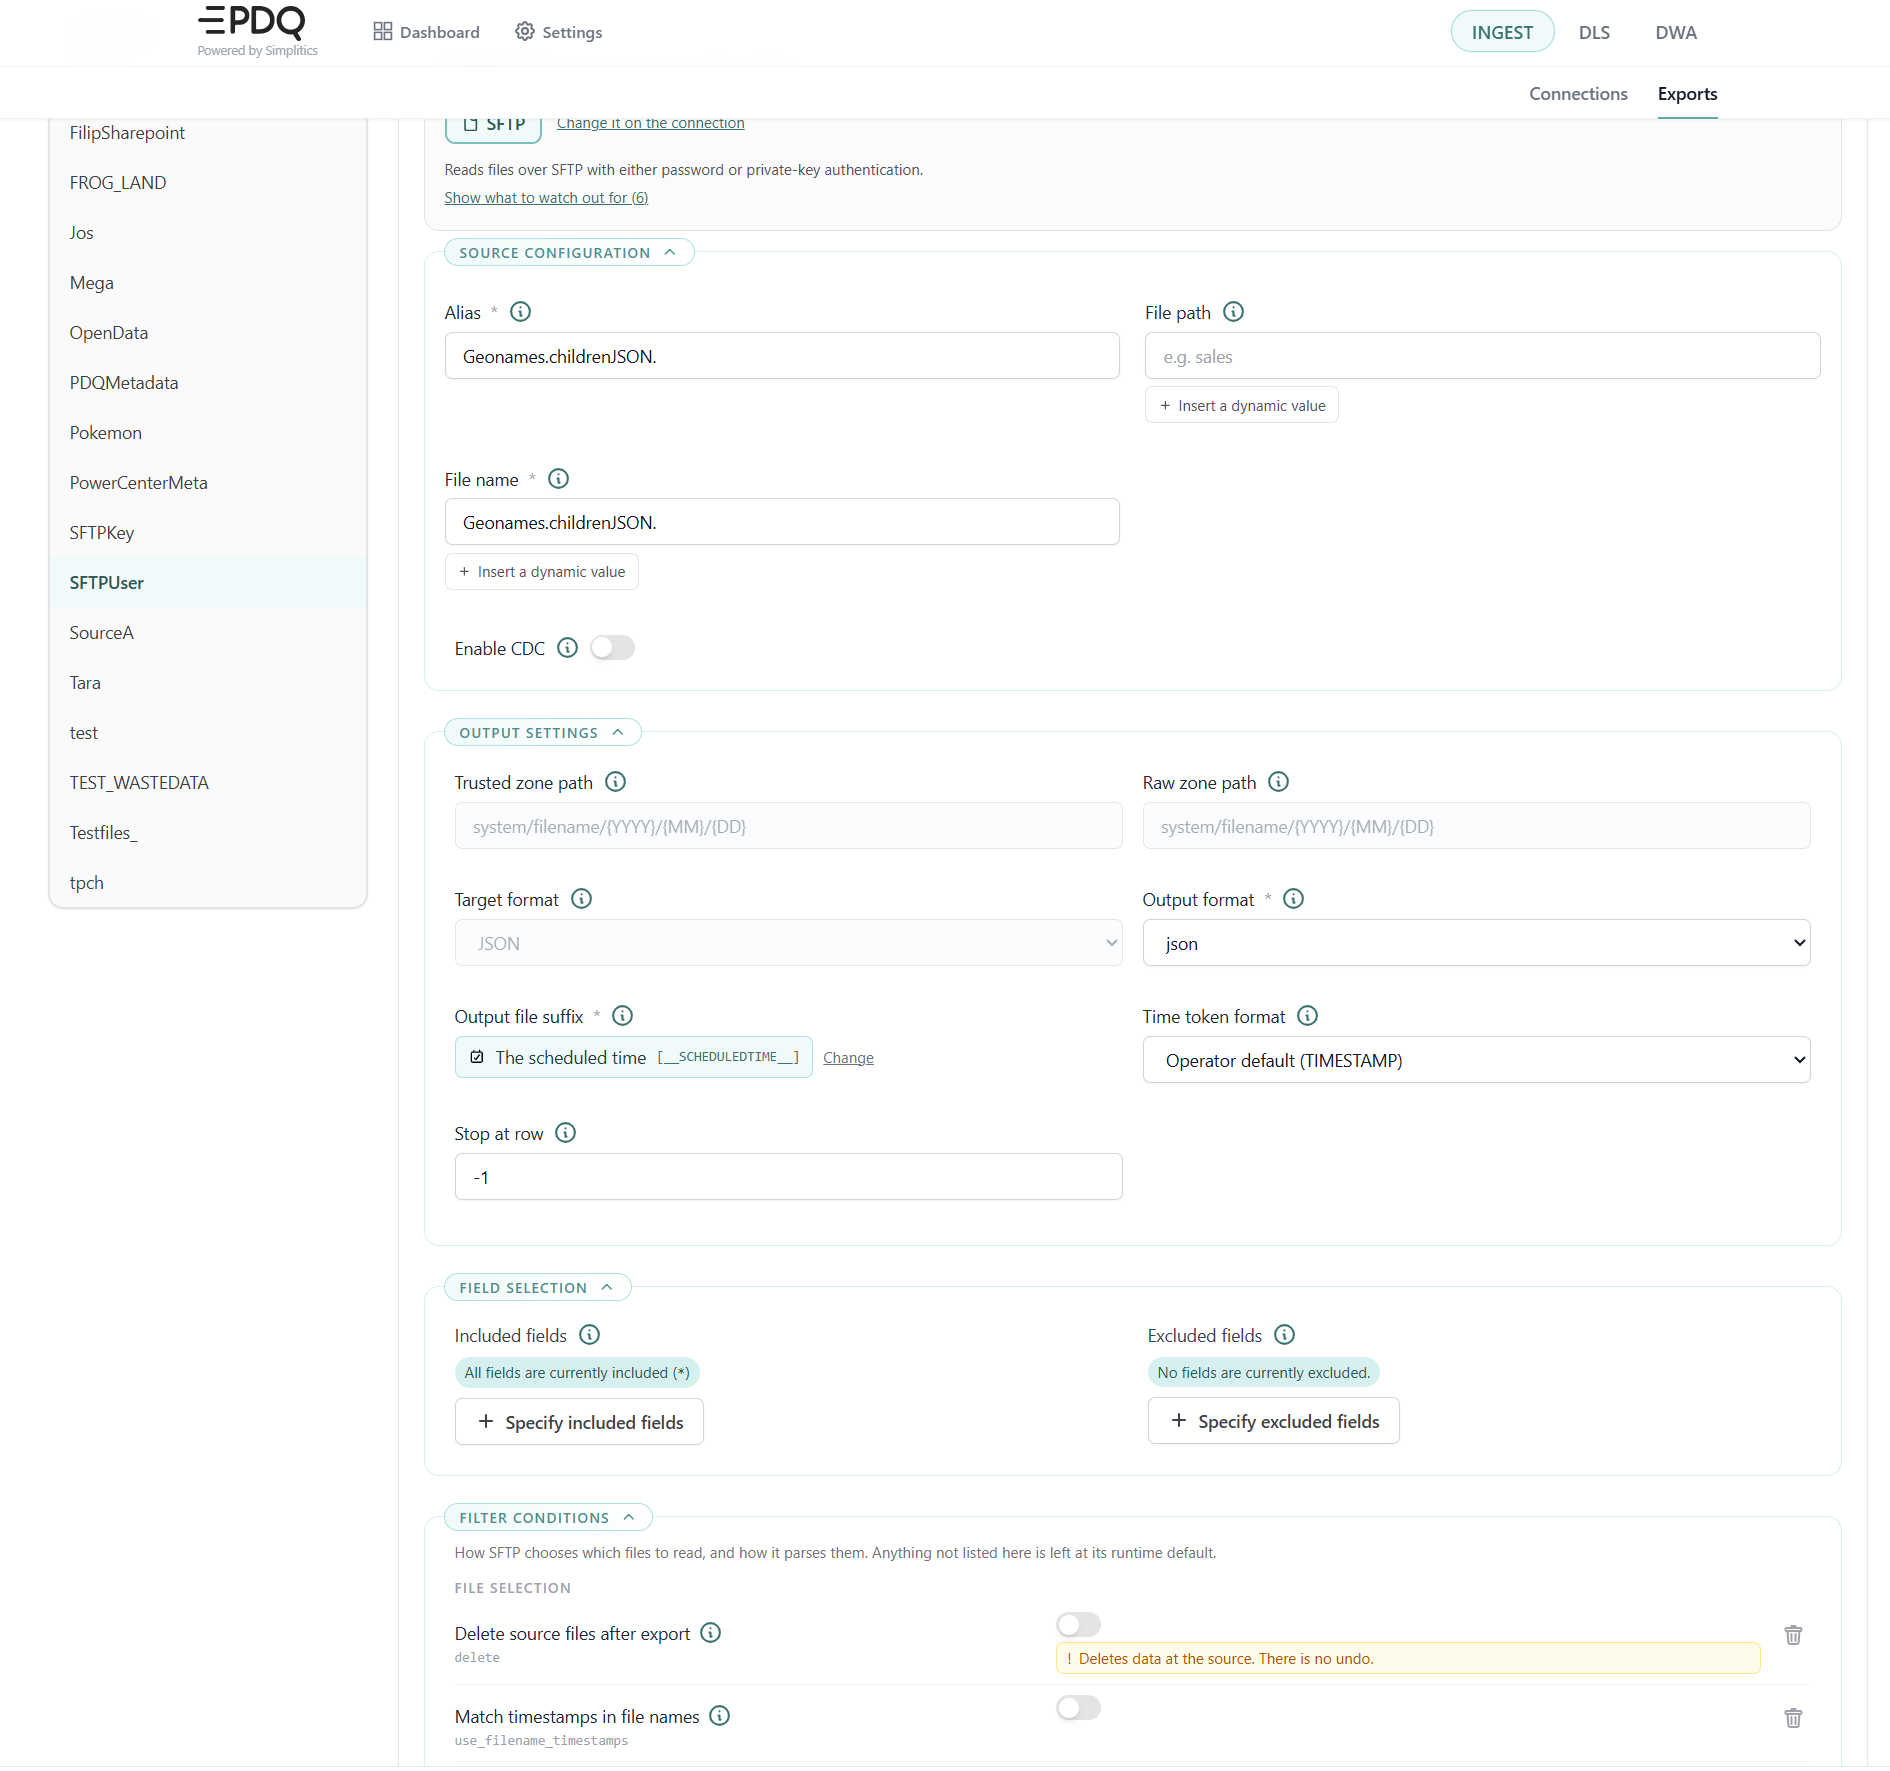
File path (filePath): Katalogprefix som läggs till efter anslutningens base path. Tidstoken ersätts, så en partitionerad källa kan adresseras med [SCHEDULEDTIME_AS_HIVE].
File name (fileName): En delsträngsmatchning mot filnamnet — inte ett glob-mönster. Obligatoriskt.
Trusted zone path, Raw zone path och Target format visas skrivskyddade; de hanteras i Settings.
Filtervillkor väljer vilka filer som läses och hur de tolkas. Filurvalet erbjuder delete (tar bort källfilerna efter en lyckad kopiering — det går inte att ångra), use_filename_timestamps, file_timestamp_format, samt ett fönster med start_timestamp / end_timestamp som accepterar dynamiska värden. S3 erbjuder dessutom find_partitions. Läsarinställningarna täcker Excel-blad och cellområde, CSV-rubrikrad, samplingsstorlek och teckenkodning, samt DuckDB:s JSON-läsare.
Custom- och köexporter
Köexporter bär inga egna källkoordinater — kön ligger på anslutningen. En körning tömmer kön till en eller flera batchfiler som heter <alias>_<suffix>_batch<NNNNNN>.txt och avslutas sedan; en tom kö skriver ingenting alls.
Filtervillkor överstyr här de tre batchgränserna enbart för den här exporten: max_batch_bytes, max_batch_seconds och max_batches_per_run.
Leverans sker minst en gång — kvittering sker efter fsync, per mottagen batch — och felaktiga meddelanden vidarebefordras med en __parseError-markering i stället för att lämnas kvar i kön.
Setting up a New Database Ingestion Flow (Code)
Setting up a new database ingestion flow involves several key steps to ensure data is accurately and efficiently extracted from your source database and loaded into your target system. Follow the steps below to configure and initiate a new database ingestion flow.
Extracting Data from an Internal Database and Writing the Content to the Data Platform
A step-by-step guide for automating the "pull data pattern." This involves extracting and loading data into the landing bucket on a scheduled basis. We need a reliable method to extract data from databases, APIs, file systems or queues on a fixed schedule.
To set up a new data export, you need to create an instruction JSON. Each export must be linked to a pre-defined source connection.
First, check for Existing Source Connection:
Is there an existing source connection?
Yes: Skip to Step 2.
No: Follow Step 1.
Steg 1: Definiera en ny källanslutning
Skapa en JSON-definition enligt följande mall:
{
    "Type": "DB",
    "DB": {
        "sourceSystem": "NewSystemName",
        "DBNm": "databaseName",
        "DBAlias": "AliasForInternalReference",
        "DBServerAddr": "databaseserver.at.hostname.com",
        "DBServerPort": "5432",
        "DBUsr": "UserName",
        "DBUsrPwd": "EncryptedString",
        "DBEncryptedConnection": "yes",
        "DBTrustCertificate": "no",
        "AddServiceColVal": "",
        "ColumnDelimiter": "|",
        "LineDelimiter": "\\n"
    }
}
Beskrivning av parametrar för databasanslutning Type: Anslutningstypen. En av DB, API, FILE eller CUSTOM. Vilken databasmotor agenten använder konfigureras som
sourcetypei agentens egensettings.yaml, inte här — PostgreSQL, SQL Server, Oracle och MySQL stöds. DB: Objektet som bär fälten för databasanslutningen. sourceSystem: Ett namn som binder anslutningen till en intern referens. Helst samma namn på källsystemet som används i övriga referenser i Simplitics. DBNm: Namnet på databasen du vill ansluta till. För Oracle är detta service name. DBAlias: Endast informativt — det används inte för att nå servern. DBServerAddr: Serveradressen som krävs för anslutningen. DBServerPort: Portnumret för databasservern. 5432 PostgreSQL, 1433 SQL Server, 1521 Oracle, 3306 MySQL. DBUsr: Användarnamnet som används för anslutningen. DBUsrPwd: Lösenordet som används för anslutningen. Det måste krypteras innan det postas till API:et. Använd krypteringsendpointen och klistra in den returnerade hashen som lösenord. Observera att API:et krypterar allt det tar emot — posta därför aldrig tillbaka ett värde som redan är krypterat, det skulle krypteras två gånger och anslutningen skulle sluta fungera vid nästa export. DBEncryptedConnection:yesbegär en krypterad anslutning till servern. DBTrustCertificate:yesaccepterar serverns certifikat utan att validera det — vilket är vad en intern server med självsignerat certifikat behöver. På SQL Server blir dettaTrustServerCertificate. AddServiceColVal: (Valfritt) Om angivet läggs en__service-kolumn till på varje rad med det angivna värdet. ColumnDelimiter: Fältavgränsaren som används när CDC skriver CSV-utdata. Ignoreras för JSON. LineDelimiter: Läses men respekteras inte av de flesta operatorer — de tvingar\n.
Ladda upp definitionen till INGEST:
- Använd API-definitionen i Swagger:
/api/v3/ingest/connection/for/:sourceSystem. - Ersätt
:sourceSystemmed det namn du angett. Om ditt källsystem till exempel heterNewSystemNameblir endpointen/api/v3/ingest/connection/for/NewSystemName.
Steg 2: Definiera en ny källexport
Bygg en JSON-definition enligt följande mall:
{
    "sourceSystem": "NewSystemName",
    "databaseName": "databaseName",
    "fromClause": "schema.main-table-or-view",
    "inclTables": [
        "schema.table1",
        "schema.table2"
    ],
    "alias": "NewSystemName.main-table-or-view",
    "suffix": "[__SCHEDULEDTIME__]",
    "dateTimeFormat": "DATETIME",
    "outputFormat": "json",
    "inclColumns": [
        "*"
    ],
    "exclColumns": [],
    "whereClause": "",
    "sqlOverride": "",
    "filterColumn": "",
    "lastFilterValue": "",
    "stopAtRow": -1,
    "substitutions": [],
    "enableCDC": 0,
    "scheduleCycle": "daily",
    "scheduleCycleInterval": 1,
    "scheduleDoNotStartBeforeTime": "02:00:00"
}
Parametrar för databasexport sourceSystem: Ett namn som binder anslutningen till en intern referens. Helst samma namn på källsystemet som används i övriga referenser i Simplitics. databaseName: Namnet på databasen du vill ansluta till. fromClause: Anger tabell, funktion, vy eller procedur att bygga SQL-frågan mot, utom när
sqlOverrideanvänds. Den måste vara schemakvalificerad — metadatauppslaget delar på punkten. inclTables: En lista över alla tabeller som data exporteras från. Detta säkerställer att data extraheras med rätt datatyper. En tom lista faller tillbaka på from-satsen. Använd den för att lista varje objekt bakom en vy eller procedur, så att kolumntyperna löses upp rätt. alias: Filnamnet som används för exporterad data. Det används av nedströmsprocesser för att identifiera datan och är löst kopplat tillfilenamePatterni källfilsdefinitionen i DLS. Observera att flera olika exporter kan skrivas till en och samma DLS-källfil. Det är också stammen i CDC:s baslinjefil,<alias>_latestversion.txt. suffix: Lägger till information i det skrivna filnamnet. Det tar emot en litteral sträng eller ett dynamiskt tidsvärde:
[EXECUTIONTIME]: Nu, i agentens konfigurerade tidszon.[SCHEDULEDTIME]: Den lucka körningen hör till. Sena körningar lägger till den planerade schematidsstämpeln, inte den faktiska körningstidsstämpeln.[LASTEXECUTION]: Föregående lyckade körnings schemalagda tid. Användbar för att beskriva den äldsta möjliga datan i exporten.Var och en tar emot en valfri
MINUS<N>_<UNIT>-förskjutning och en valfriAS<FORMAT>-rendering — till exempel[SCHEDULEDTIME_MINUS_1_DAYS_AS_DATE]. Det finns ingenPLUS. Se Dynamiska tidsvärden under fliken Exporter för hela grammatiken. dateTimeFormat: Den exportgemensamma renderingen som används av varje tidsvärde som inte bär ett egetAS-segment.DATETIMEför databaskällor,TIMESTAMPi övrigt. Alla andra värden behandlas som ett litteralt mönster byggt av[YYYY][YY][MM][DD][HH][MI][SS]. outputFormat:json,csvellerbinary. inclColumns: Anger vilka kolumner som ska ingå i den exporterade filen. Du kan använda aliassyntax i listan, till exempel["Id as fileId", "text as description"]. Det går också att använda kolumnberäkningar i giltig SQL-syntax. Använd*för att inkludera alla tillgängliga kolumner. exclColumns: På en databasexport tar detta inte bort kolumner — det stänger bara av typkonvertering och ekas ut i körningsloggen. Ta i stället bort kolumner fråninclColumns. På API-, fil- och köexporter är det en äkta neka-lista som tillämpas efter tillåt-listan. whereClause: Lägger till filtrering i exportfrågan. Den infogas ordagrant, så den måste innehålla nyckelordetWHERE, och ett inkrementellt filter läggs till medAND. Använd källans egna kolumnnamn för att undvika SQL-fel. Dynamiska tidsvärden ersätts här, så det är så här du exporterar bara det som ändrats sedan senaste körningen:WHERE MyDatabaseLoadingTimestampColumn > '[__LASTEXECUTION__]'sqlOverride: Åsidosätter den SQL som genereras utifrån attributen ovan och kör i stället den SQL som anges här. Användbart för underfrågor och joins när du inte kan skapa vyer, funktioner eller procedurer i källan. Dynamiska tidsvärden gäller även för
sqlOverride, men det inkrementella filtret läggs inte till — bygg in det själv. filterColumn: Aktiverar inkrementell laddning. Jämförelsen är numerisk, så kolumnen måste vara ett stigande tal. lastFilterValue: Vattenmärket från föregående körning, som postas tillbaka till AME efter varje körning.0vid första körningen. stopAtRow: Standardvärdet är -1, vilket innebär att processen läser all data som frågan levererar. Anges ett positivt heltal stannar processen när radantalet når det värdet. Observera att databasoperatorerna räknar chunkar om 25 000 rader i stället för enskilda rader. substitutions: Transformerar data löpande under exporten. Användbart för null-ersättningar och hantering av viss känslig data. Formatet är anpassat för Pythons transform-funktion. Här är två olika användningsfall:[
{
"column": "customerId",
"type": "null",
"replace": ""
},
{
"column": "SSN",
"replace": " str(SSN)[:4] if len(str(SSN)) == 12 else '' ",
"alias": "birthYear",
"type": "transform"
}
]Uttrycket
replaceevalueras medeval()— behandla exportdefinitioner som betrodd kod. enableCDC: 1 betyder aktiverad, 0 betyder avstängd.enableCDC = 1aktiverar radvis change data capture, där alla kolumnvärden jämförs mot den senast exporterade raden. Endast nya, borttagna eller ändrade poster exporteras. Agenten håller baslinjen lokalt, i filen<alias>_latestversion.txtinuti sin egen container, så jämförelsen överlever en omstart — det är vad filen finns för. Den överlever inte att containern förstörs eller tas bort: nästa körning exporterar då allt en gång och bygger upp en ny baslinje. Att kombinera enableCDC = 1 med dynamisk filtrering i whereClause gör att rader som filtret utesluter rapporteras som borttagningar. Använd det ena eller det andra. scheduleCycleInterval: Ett heltal (t.ex. 1) som avgör hur ofta schemat körs. Schemaläggaren räknar upp med detta värde i kombination med typen ischeduleCycle. scheduleCycle: Anger typen av schema för exporten. Möjliga värden:
- never — exporten förblir definierad men schemaläggs inte
- minute
- hourly
- daily
- monthly
Detta avgör tidsenheten somscheduleCycleIntervalräknas upp med frånscheduleDoNotStartBeforeTime.
scheduleDoNotStartBeforeTime: Startpunkten för varje uppräkning, angiven som HH:MM:SS. Till exempel betyder02:00:00att uppräkningen börjar klockan 02. OmscheduleCycleärhourlyochscheduleCycleIntervalär2körs exporten varannan timme med start klockan 02.
Ladda upp definitionen till INGEST:
- Använd API-definitionen i Swagger:
/api/v3.1/ingest/definition/for/:sourceSystem/:alias.
Steg 3: Validera
Om inhämtningscontainern körs för den angivna sourceSystem-anslutningen körs den nydefinierade exporten vid nästa schemalagda tillfälle, förutsatt att dagens scheduleDoNotStartBeforeTime har passerat. Data laddas till den tidigare definierade datalagringen, i det här fallet landningshinken. Logga in på ditt molnkonto och kontrollera landningshinken för att verifiera datan.
Installation av INGEST-agenten
Starta en ny Docker-container med sourceSystem som körningsparameter. Containern använder den angivna anslutningen och kör alla kopplade instruktioner enligt det angivna batchschemat. Se driftssättningsguiden för detaljerade instruktioner om hur containern startas.
Tekniska specifikationer
INGEST (per 2024-04-15)
Runs as a container (1 per source connection). Built using Docker. Python 3.12 on Debian 12. Code is hosted in Bitbucket, and containers are published on Docker Hub.
The agent picks one operator class per source system, configured as sourcetype in its settings.yaml. Each operator reads a different subset of the connection fields, connection properties, export fields and filter conditions; the Config UI derives its forms from the same registry.
Python-beroenden, requirements.txt (per 2024-04-15)
requestspyodbcsqlalchemypandaspytzoauth2clientpyyamlpsycopg2msrestazureazure-commonazure-storage-blobazure-storage-commonazure-storage-file-datalakeazure-datalake-storeboto3duckdb
Operatornoteringar värda att känna till
- Databaser strömmar en SQL-fråga genom pandas i chunkar. Chunkstorleken är fast på 25 000 rader, och en
__checksum-kolumn läggs till per post, vilket möjliggör den snabba CDC-vägen. Oracle behöver Oracle instant client och körs därför bara i containern. MySQL använder en cursor på serversidan, så stora tabeller materialiseras inte i minnet. - API:er gör ett nytt försök efter en enskild token-förnyelse vid 401. En 404, valfri status från 400 och uppåt, samt en Content-Type som inte går att avgöra får alla arbetsuppgiften att misslyckas.
- Filsystem upptäcker formatet i ordningen .xlsx, .parquet, JSON, CSV, var och en undersökt med en LIMIT; filer som inte går att avgöra faller tillbaka på en binär kopiering. Alla matchade filer läses i en enda omgång, så de måste dela schema eller förlita sig på union efter namn. DuckDB är begränsat till 2 trådar och 2 GB minne.
- Köer töms till batchfiler och avslutas sedan, i stället för att loopa. Leverans sker minst en gång, och den här familjen är tänkt för små meddelanden — landa stora payloads i blob-lagring och hämta in dem med en filsystemsoperator.
Driftsättning och körning
- Applikationen kan köras i vilken containerbaserad miljö som helst. Det är att föredra att köra den nära datakällan, men det är inget hårt krav.
- Applikationen genererar ingen kod. Den använder JSON-baserad konfiguration som indata och skriver data till den definierade målplattformen.