Data Warehouse Automation (DWA)
Vad du kommer lära dig i avsnittet "Arbeta med DWA":
Modeller: Strukturerade representationer av dataentiteter och deras relationer i datalagret. Modeller definierar hur data organiseras, lagras och nås.
Mappningar: Nödvändiga för att transformera och integrera data från olika källor till en enhetlig modell. Avsnittet täcker stegen och bästa praxis för att skapa och hantera mappningar.
Ytterligare uppgifter: Egna för- och efterbearbetningssteg som körs som en del av pipelinen runt de genererade laddningarna.
DWA-modulen har tre sidor i Config UI — Models, Mappings och Additional Tasks — som nås från DWA i den övre navigeringen.
- Hur man arbetar med modeller
- Hur man arbetar med mappningar
- Ytterligare uppgifter
- Tekniska detaljer
På sidan DWA → Models (/models) väljer och konfigurerar du modellobjekt, redigerar deras attribut, definierar deras relationer och visualiserar dem som ett ERD.
Modeller listas i en sökbar sidopanel; Add Object skapar en ny. Alla ändringar hålls lokalt tills du trycker på Save model.
Modellkonfiguration
Object: Namnet på modellobjektet — en specifik entitet eller tabell i datalagret. Det kan inte ändras när objektet väl finns.
Description: En kort beskrivning av modellobjektet. Obligatoriskt.
Loading Pattern: Hur objektet laddas. En av transaction, dayspan, incremental, full eller none.
Object Type: Specific eller Combined.
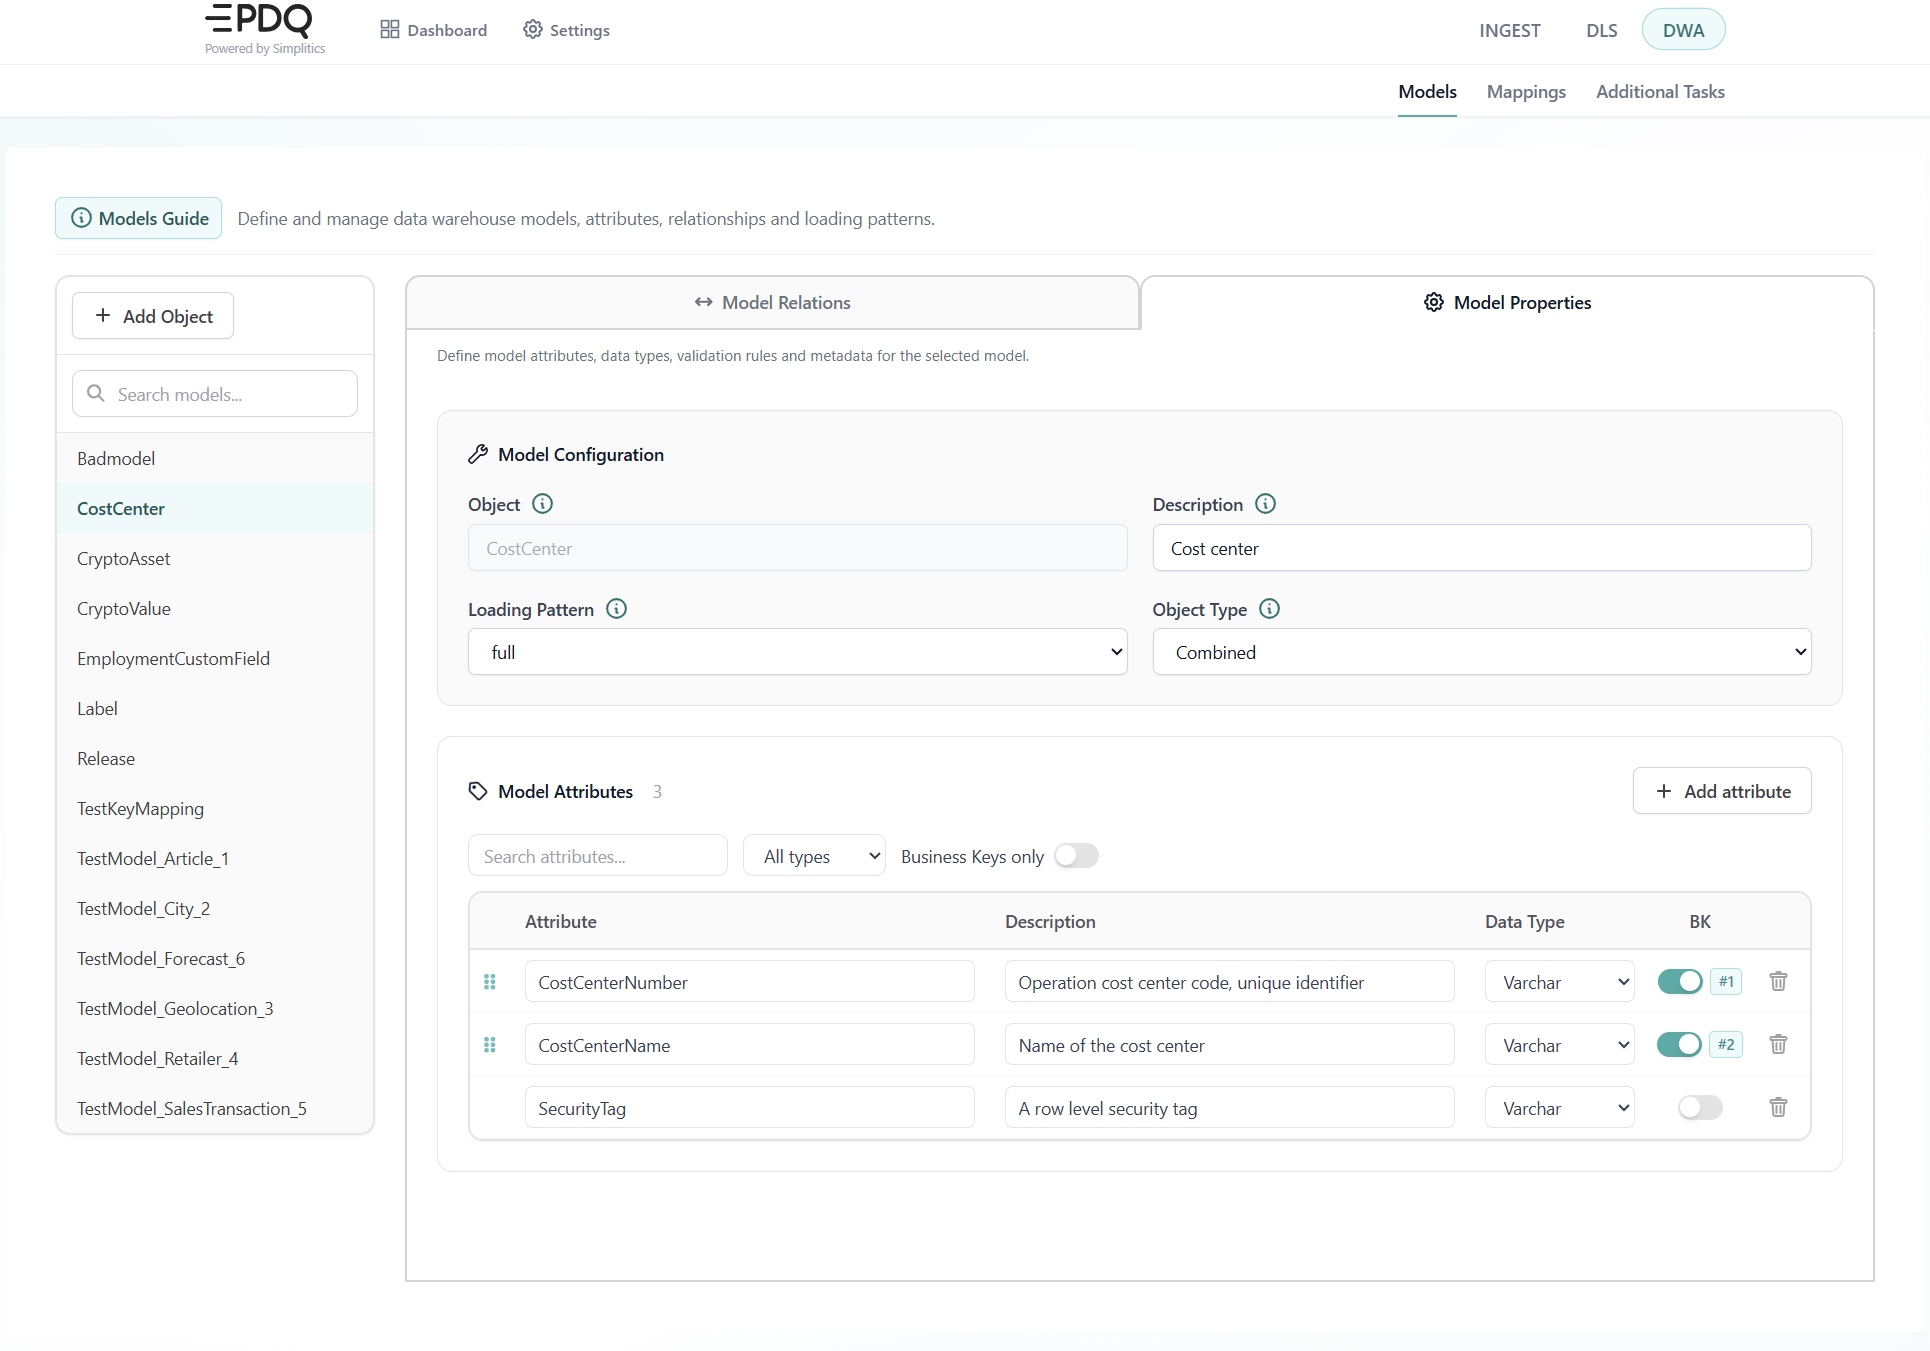
Attribut
- Attribute — det unika namn som identifierar attributet inom modellen.
- Description — en kort förklaring av vad attributet representerar.
- Data Type — Varchar, Integer, Decimal, Boolean, Time, Date eller Timestamp. Alternativet Other tar emot en egen typ, och ett sparat värde som inte är standard upptäcks och visas som sådant.
- BK — om attributet ingår i affärsnyckeln.
Fliken Model Properties listar objektets attribut i en tabell med fyra kolumner:
Attributrader kan dras för att ändra ordning, och för affärsnycklar sätter ordningen affärsnyckelns prioritet — varje affärsnyckelrad numreras. En sökruta och filtret Business Keys only smalnar av en lång lista.
Attribut läggs till med knappen under listan och tas bort med papperskorgsikonen på raden. Ingenting träder i kraft förrän Save model trycks.
Model Relations
- Many-to-Many — slå på växlaren.
- Parent-Child — låt växlaren vara av. Detta är standard, och to object är förälder i relationen.
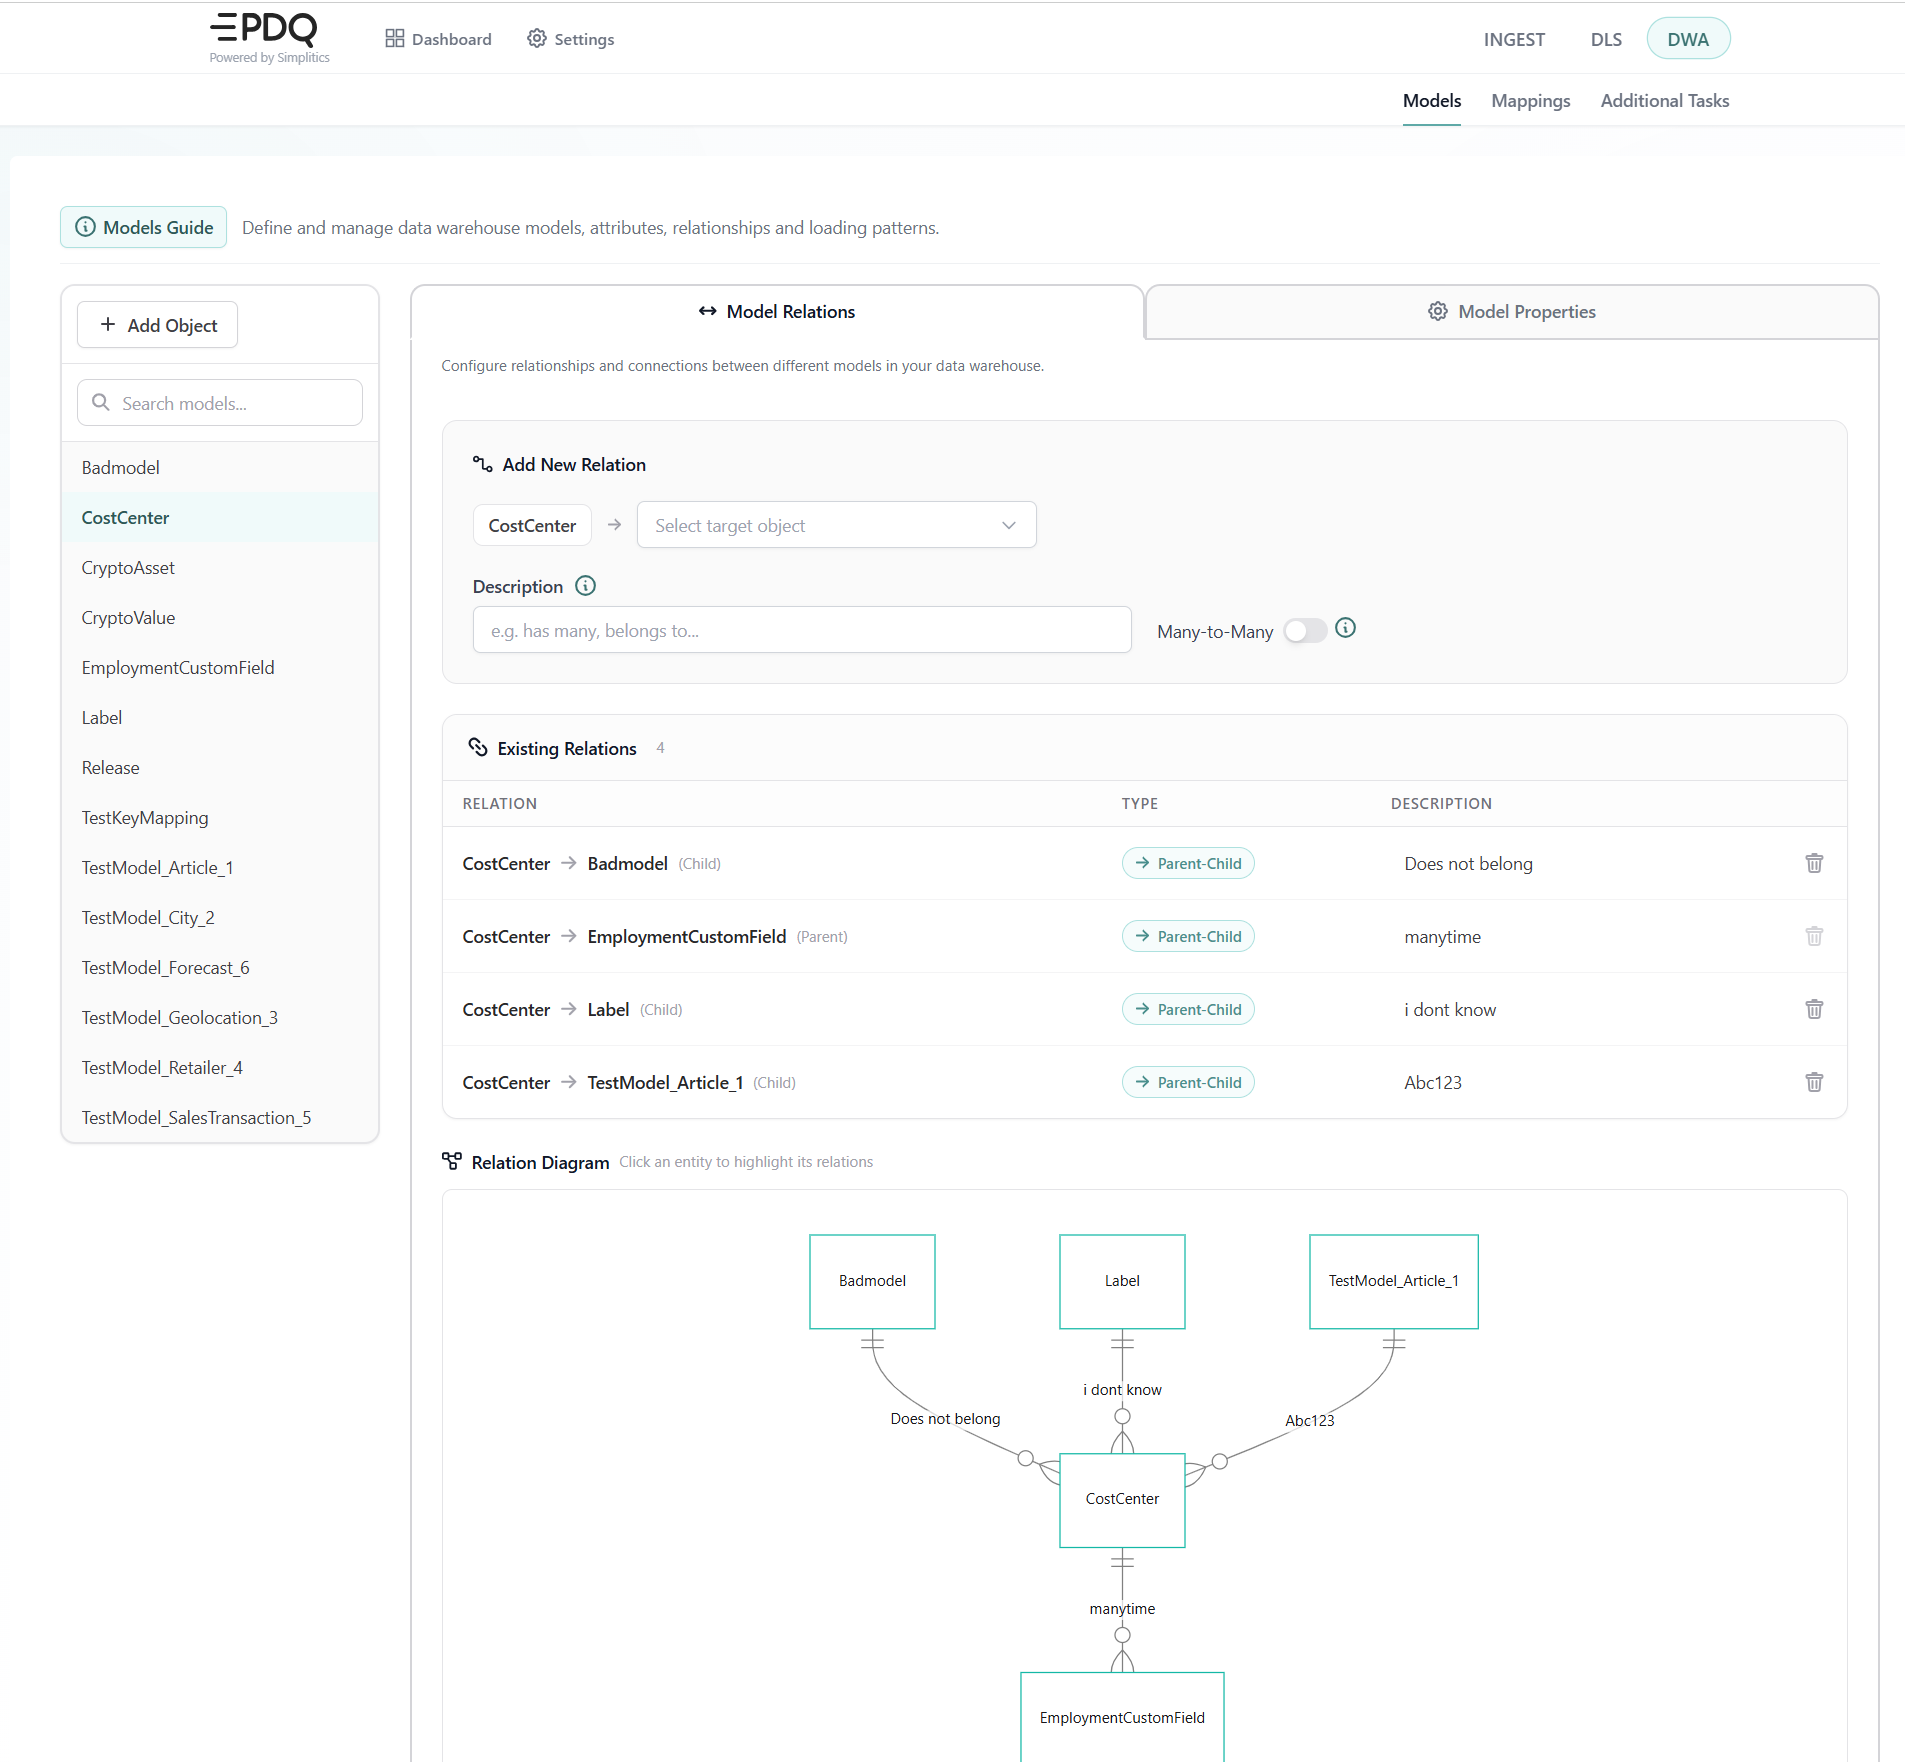
Fliken Model Relations hanterar hur det valda objektet kopplas till övriga.
Lägg till en relation genom att välja To object i en sökbar lista och ge den en beskrivning (till exempel "har många", "tillhör"). Växlaren Many-to-Many avgör typen:
Bakom växlaren sitter relationRole, som anger vilken ände det här objektet är: parent,
child, eller many i en många-till-många. Det är inte relationens beskrivning — beskrivningen är
ett separat fritextfält. Utan angivet värde defaultas relationRole till parent-child.
Befintliga relationer listas med sin riktning markerad av en ikon, en redigerbar beskrivning och en borttagningsåtgärd.
Befintliga relationer listas under formuläret med sin typ och beskrivning, och Relation Diagram nedanför ritar det valda objektet tillsammans med allt det är relaterat till. Klicka på en entitet i diagrammet för att markera dess relationer.
Visualisera en modell
- Full model ERD: Öppnar hela entitets-relationsdiagrammet i en modal, med en växlare för att visa attribut.
- Object visualization: Öppnar det valda modellobjektet tillsammans med de objekt det har relationer till.
- Show SQL: Öppnar SQL:en för den valda modellen.
Vad modellen producerar i måldatabasen
Modellen är inte bara indata till laddningslogiken. Den är också källan till den struktur och dokumentation som hamnar i måldatabasen, vilket är skälet till att det lönar sig att fylla i de delar som känns valfria.
| Vad du sätter på modellen | Vad generatorn genererar |
|---|---|
| Beskrivningen på ett objekt eller attribut | En tabell- eller kolumn-COMMENT inuti genererad CREATE TABLE (Snowflake och Databricks) |
| Affärsnyckeln | Ett unikt villkor på core-tabellen, och en primärnyckel på publiceringstabellen |
| En relation | En främmande nyckel, barn → förälder, avduplicerad |
| Fältklassificeringen som bärs med från källkontraktet | En kategoritagg, samt känslighetstagg och — på plattformar som stöder det — en kolumnmask för fält flaggade sensitive |
Villkorsgenerering är på som standard. En tom beskrivning är därför inte ett kosmetiskt utelämnande — den ger en odokumenterad kolumn i datalagret som inget senare steg fyller i.
På sidan DWA → Mappings (/mappings) skapar och hanterar du mappningsgrupper, mappar källfält till modellattribut och konfigurerar de transformationsregler som gäller för varje mappning.
Käll-till-mål-mappningar definierar flödet av bearbetad data från Published Data-lagret till den integrerade kärnkonceptmodellen (Integrated-lagret). DWA genererar SQL-kod och laddningsorkestrering utifrån modellbeskrivningar och käll-till-mål-mappningar (LOGIC), som lagras i Active Metadata Engine (AME).
Förutsättningar
Innan mappningarna skapas måste följande steg i Simplitics-arkitekturen vara klara:
- Datainmatning och publicering: Data måste ha bearbetats av Data Lake Service (DLS) och publicerats till Published-lagret. Published-lagret tillhandahåller valt tabellformat för den överenskomna källeveransen och möjliggör SQL-baserad dataåtkomst.
- Källdefinitioner: Källdefinitioner och datastruktur (datakontraktet/metadatan) skapas av DLS.
- Definition av integrerad modell: Den integrerade kärnaffärsmodellen måste vara definierad. Modellen använder ensemble-datamodelleringsmetodik och definitionen omfattar objektnamn, nycklar, beskrivningar, datatyper och relationer. Detta görs normalt på Models-sidan.
- Utrullning av måltabeller: De fysiska måltabellerna för den integrerade modellen (Ensemble-/Intermediate-modellen och Core-/Enterprise-modellen) måste genereras med SQL Generator-API:et eller CI/CD-verktyget och rullas ut till måldatabasen.
Mappa en källa till en modell
När modeller mappas från källdata är det avgörande att först modellera affärsnyckeln innan attributen modelleras. Utan en nyckelmappning fungerar inte laddningen. En mappning måste innehålla minst en nyckelmappning och en attributmappning; annars kan ingenting laddas.
UI:t kontrollerar numera detta åt dig: om en affärsnyckel lämnas omappad namnger en dialog exakt vad som saknas ("Nothing is mapped to Release.ReleaseId yet"), förklarar vad en affärsnyckel är och låter dig välja källfältet och trycka Map and save utan att lämna sidan. Den djuplänkar också till den aktuella modellen, med en länk Back to mappings som återställer det system, den källfil och den grupp du kom ifrån.
Steg för steg:
- Gå till sidan Mappings i Config UI.
- Välj system i sidopanelen, därefter Source (källfilen som representerar Published Data), Mapping Group och Model.
- Skapa en mappningsgrupp om ingen finns. En mappningsgrupp representerar en logisk arbetsenhet och är en samling mappningar från en källfil till en eller flera målmodeller.
- Mappa affärsnycklarna först, därefter attributen.
Nycklar
Mappa dina unika källdata till motsvarande affärsnycklar i modellen. Ordningen på mappningarna spelar ingen roll — motorn sorterar dem automatiskt utifrån den modellerade informationen. Det säkerställer att data ligger i linje med affärsmodellen och möjliggör smidig integration och analys.
Om ett modellobjekt har en sammansatt nyckel måste samtliga nyckelvärden mappas fullständigt för att objektet ska laddas.
Attribut
Mappa varje källattribut till motsvarande modellattribut, ett i taget. Mappningsgruppen delar nyckelmappningsdefinitionen, vilket betyder att alla attribut som laddas inom gruppen delar samma nyckelmappningslogik.
Relationer
Relationer upptäcks automatiskt när en och samma källfil mappar till affärsnycklarna i båda modellobjekten, förutsatt att relationen är definierad och finns i modellen. Relationer definieras i målmodellen, inte explicit i laddningsprogrammet.
Även om det kan verka nödvändigt att modellera en relation manuellt kommer systemet att etablera den automatiskt så länge källfilen kan ladda båda nycklarna. Det är avgörande att den fullständiga affärsnyckeln fylls i för båda modellobjekten i relationen. Om villkoret inte uppfylls skapar källan visserligen en relation, men också en "falsk" affärsnyckel, vilket resulterar i att ingen relaterad data blir tillgänglig.
Arbeta med mappningsgrupper
- Välj en källa och en källfil: Börja med att välja källan och den specifika källfil du ska arbeta med. Det säkerställer att du arbetar med rätt datamängd.
- Skapa en mappningsgrupp: En mappningsgrupp behöver ett namn och en beskrivning; båda är obligatoriska. Befintliga grupper kan döpas om och få ny beskrivning i samma dialog.
Vad är en mappningsgrupp?
En mappningsgrupp är en samling mappningar från en källa till en eller flera målmodeller. Den representerar en logisk arbetsenhet och kännetecknas av en delad nyckelmappningsdefinition, gemensamma sorteringsordningar och gemensamma filter. Strukturen gör att besläktade mappningar organiseras och hanteras tillsammans.
När behöver jag flera mappningsgrupper?
Du kan behöva flera mappningsgrupper i följande fall:
- Olika kolumner till samma målattribut: Om du behöver mappa två olika kolumner från en källa till ett och samma målattribut måste du skapa två olika mappningsgrupper.
- Filtrerad källa till olika mål: Om du vill mappa en del av källan med ett filter till en målmodell och en annan del till en annan målmodell behöver du två mappningsgrupper. Till exempel om källan innehåller kunder som ska delas upp i företagskunder och privatkunder.
Object Mapper
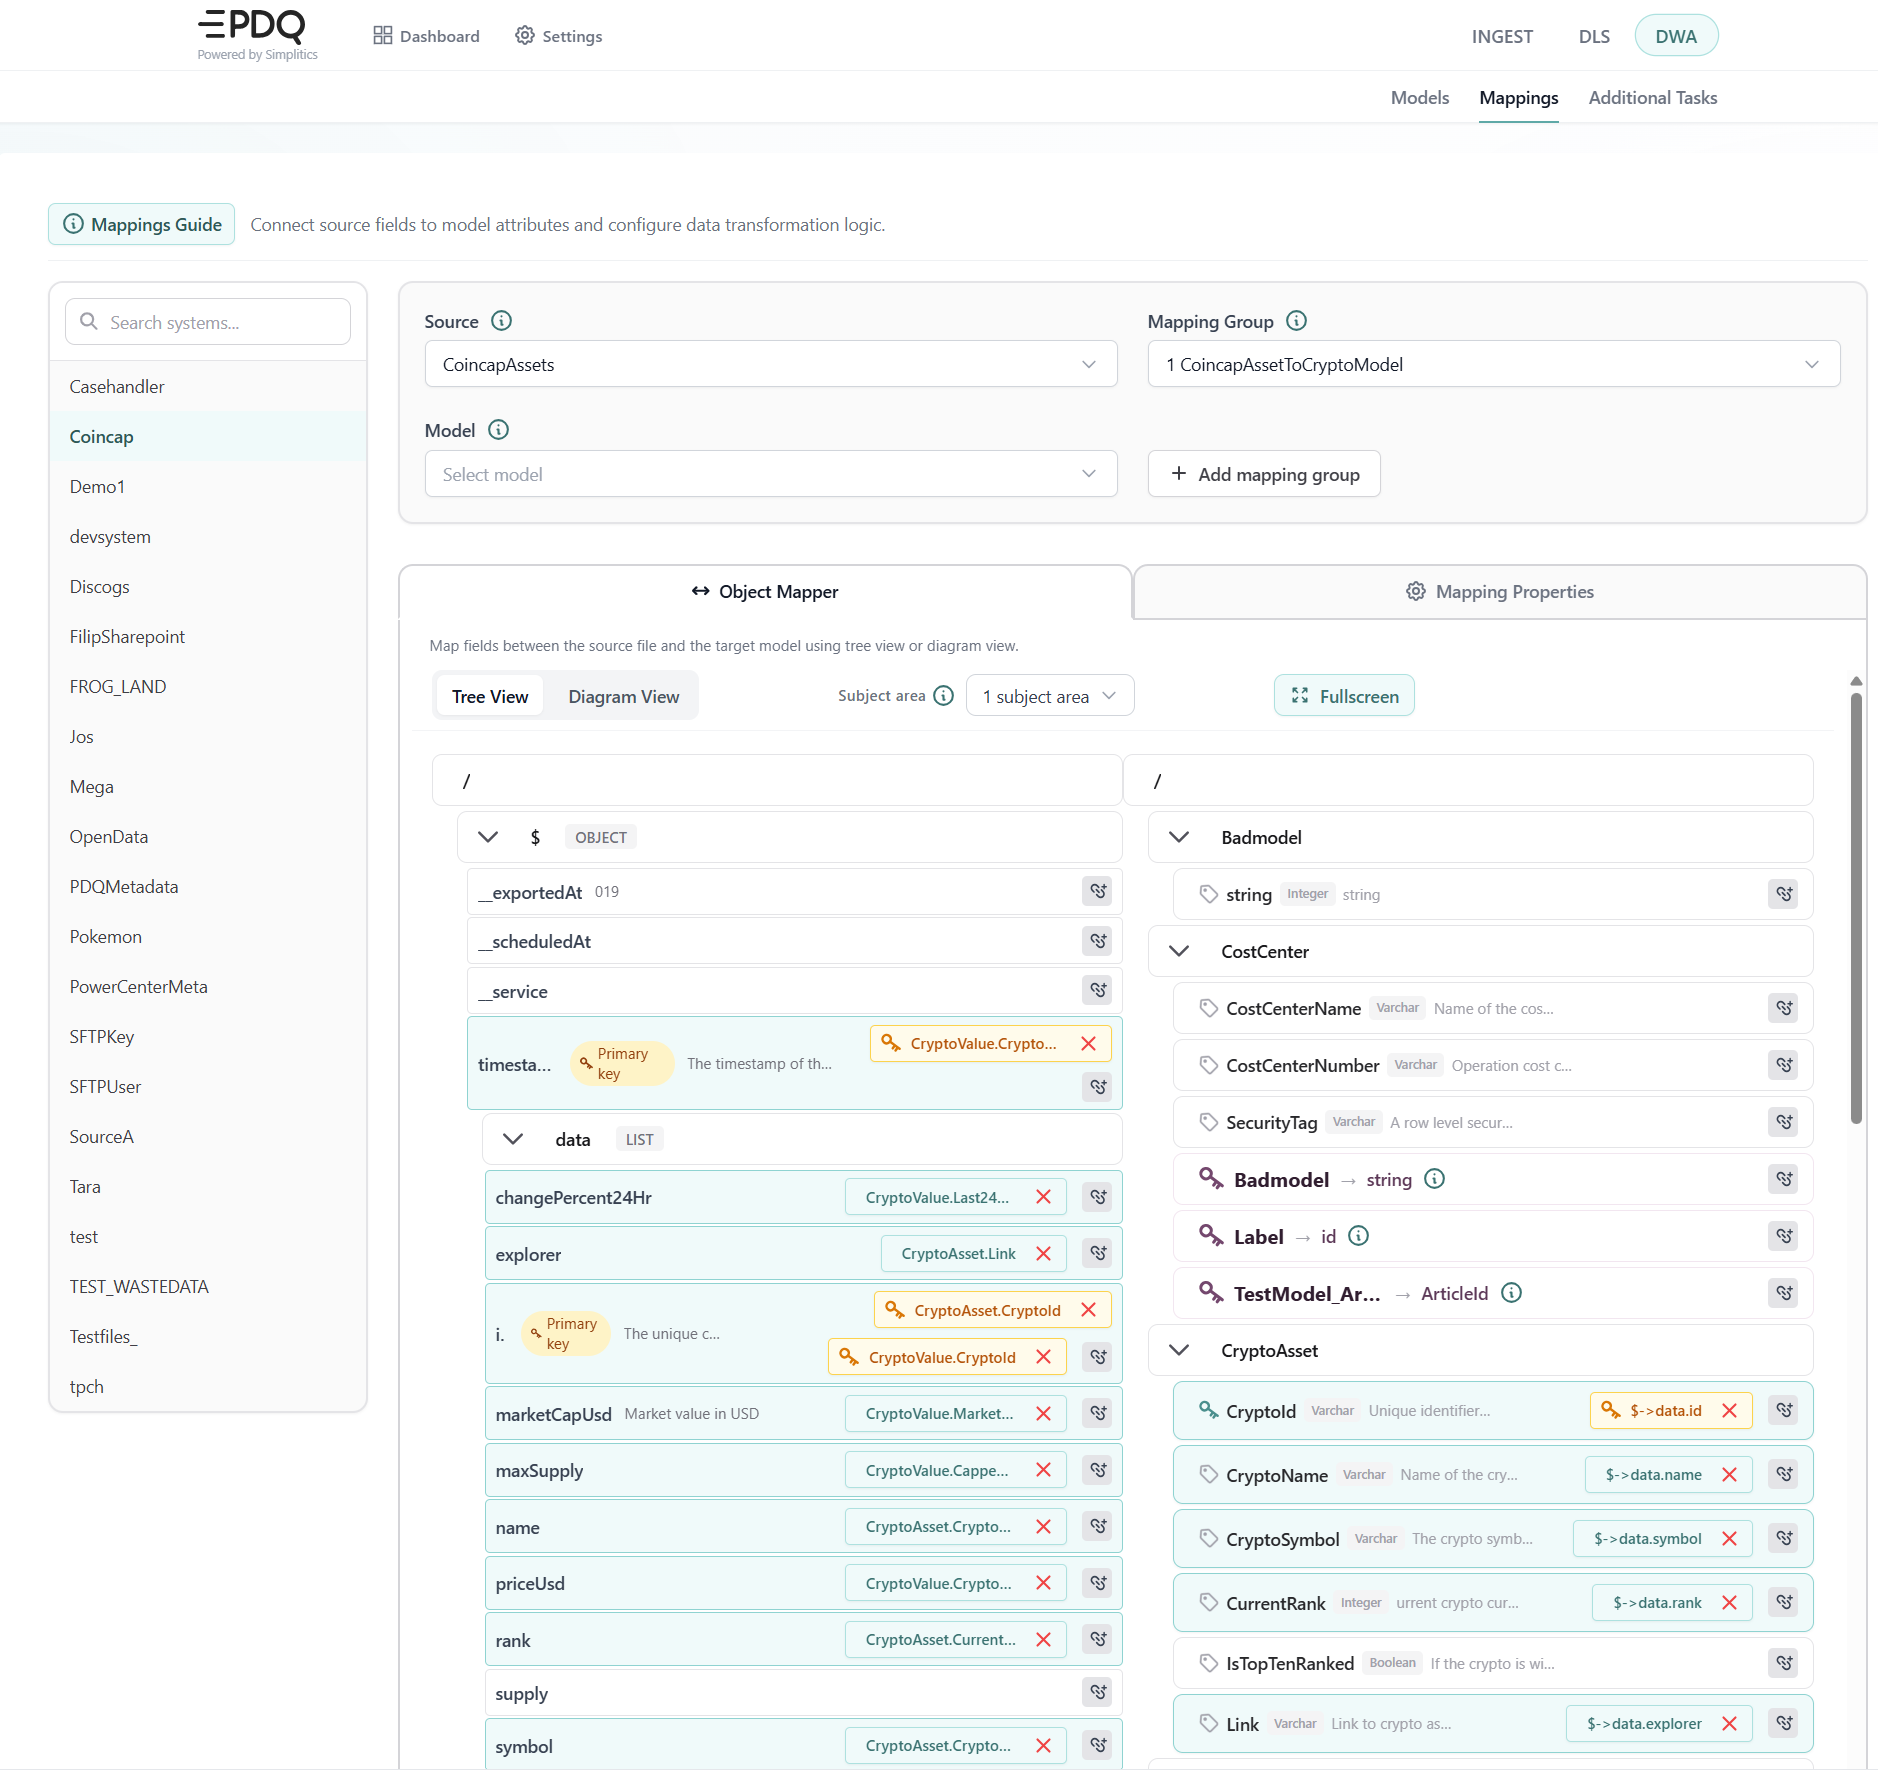
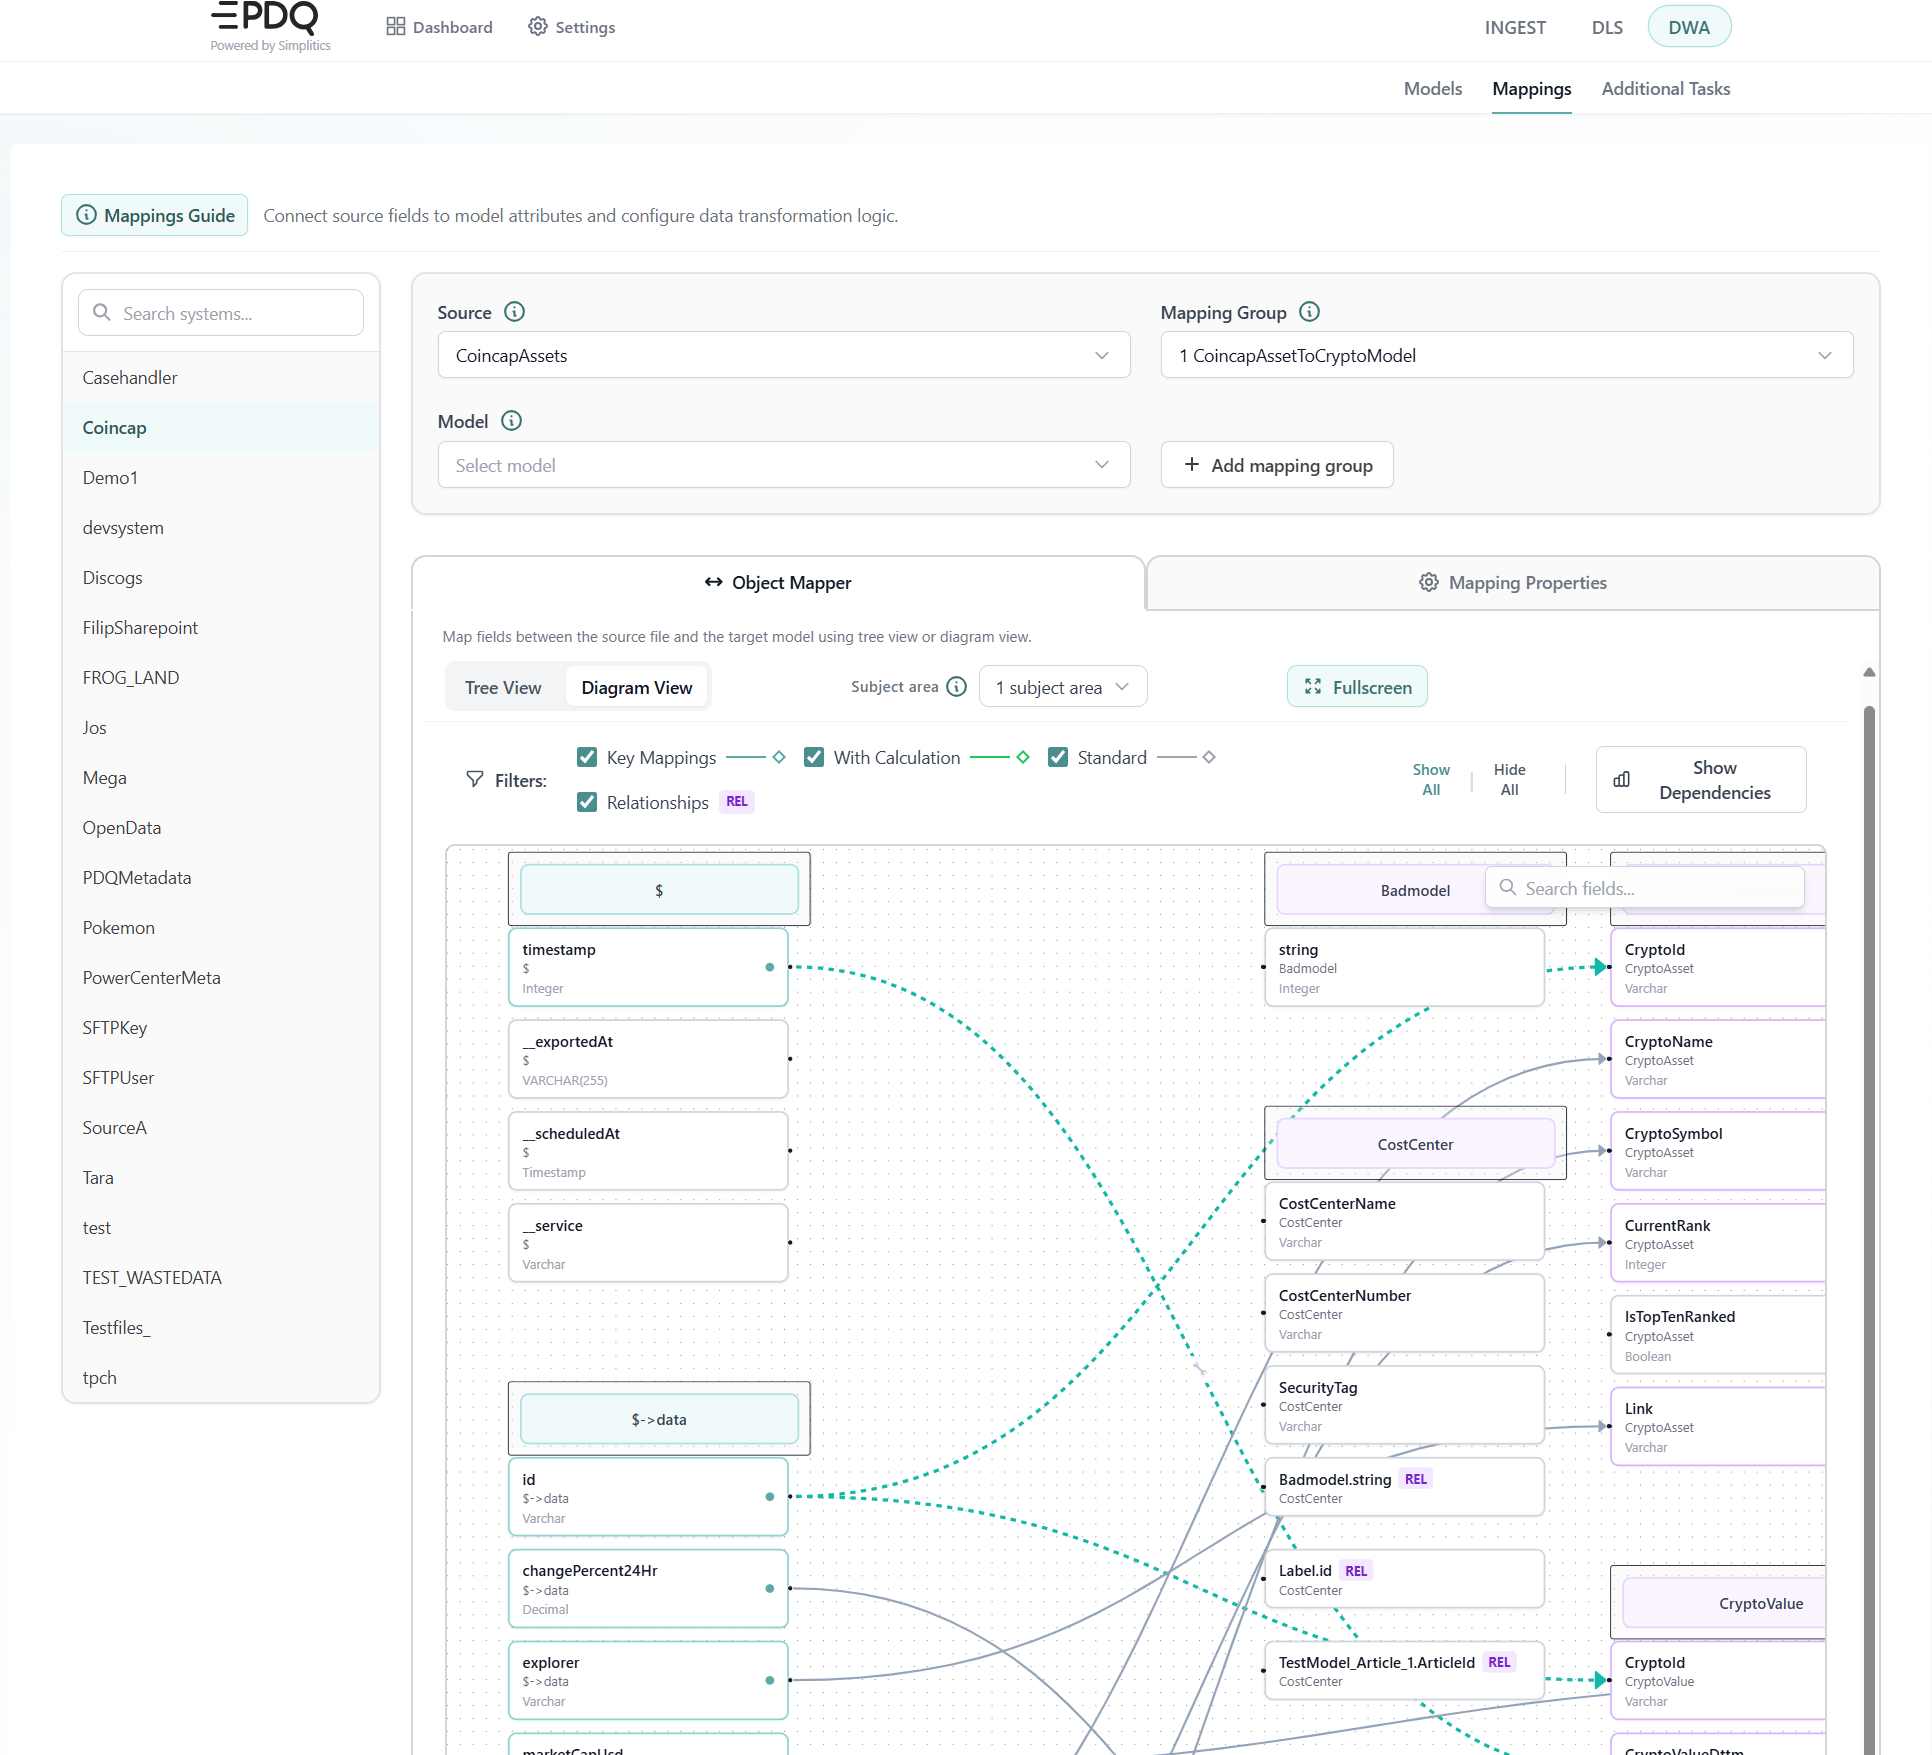
Fliken Object Mapper är där källfält kopplas till modellattribut. Den har två vylägen som växlas med en knapp:
- Diagramvyn (standard) renderar källfält och målattribut som en graf. Mappningar skapas och tas bort genom att dra mellan noder, kanter markeras vid hovring, och diagrammet kan exporteras som en bild.
- Trädvyn visar källstrukturen och målmodellen sida vid sida. Klicka på ett källfält och sedan på ett målattribut för att skapa mappningen; kedjelänksikonen med ett streck genom tar bort en. Ett valfritt mappningslinje-överlägg ritar kopplingarna över de två träden.
Båda vyerna erbjuder sökning, ett subject area-filter som begränsar målmodellerna till ett valt område, och en växlare för att bara visa mappade fält. Knappen Fullscreen öppnar samma mappare i en modal och behåller det aktuella vyläget.
Gröna markeringar visar kopplade fält. Att skapa eller ta bort en mappning rapporteras i statusraden i verktygsfältet i stället för att öppna en dialog, och mappningarna är tillgängliga för motorn så snart de sparats.
Mappningsegenskaper och avancerad logik
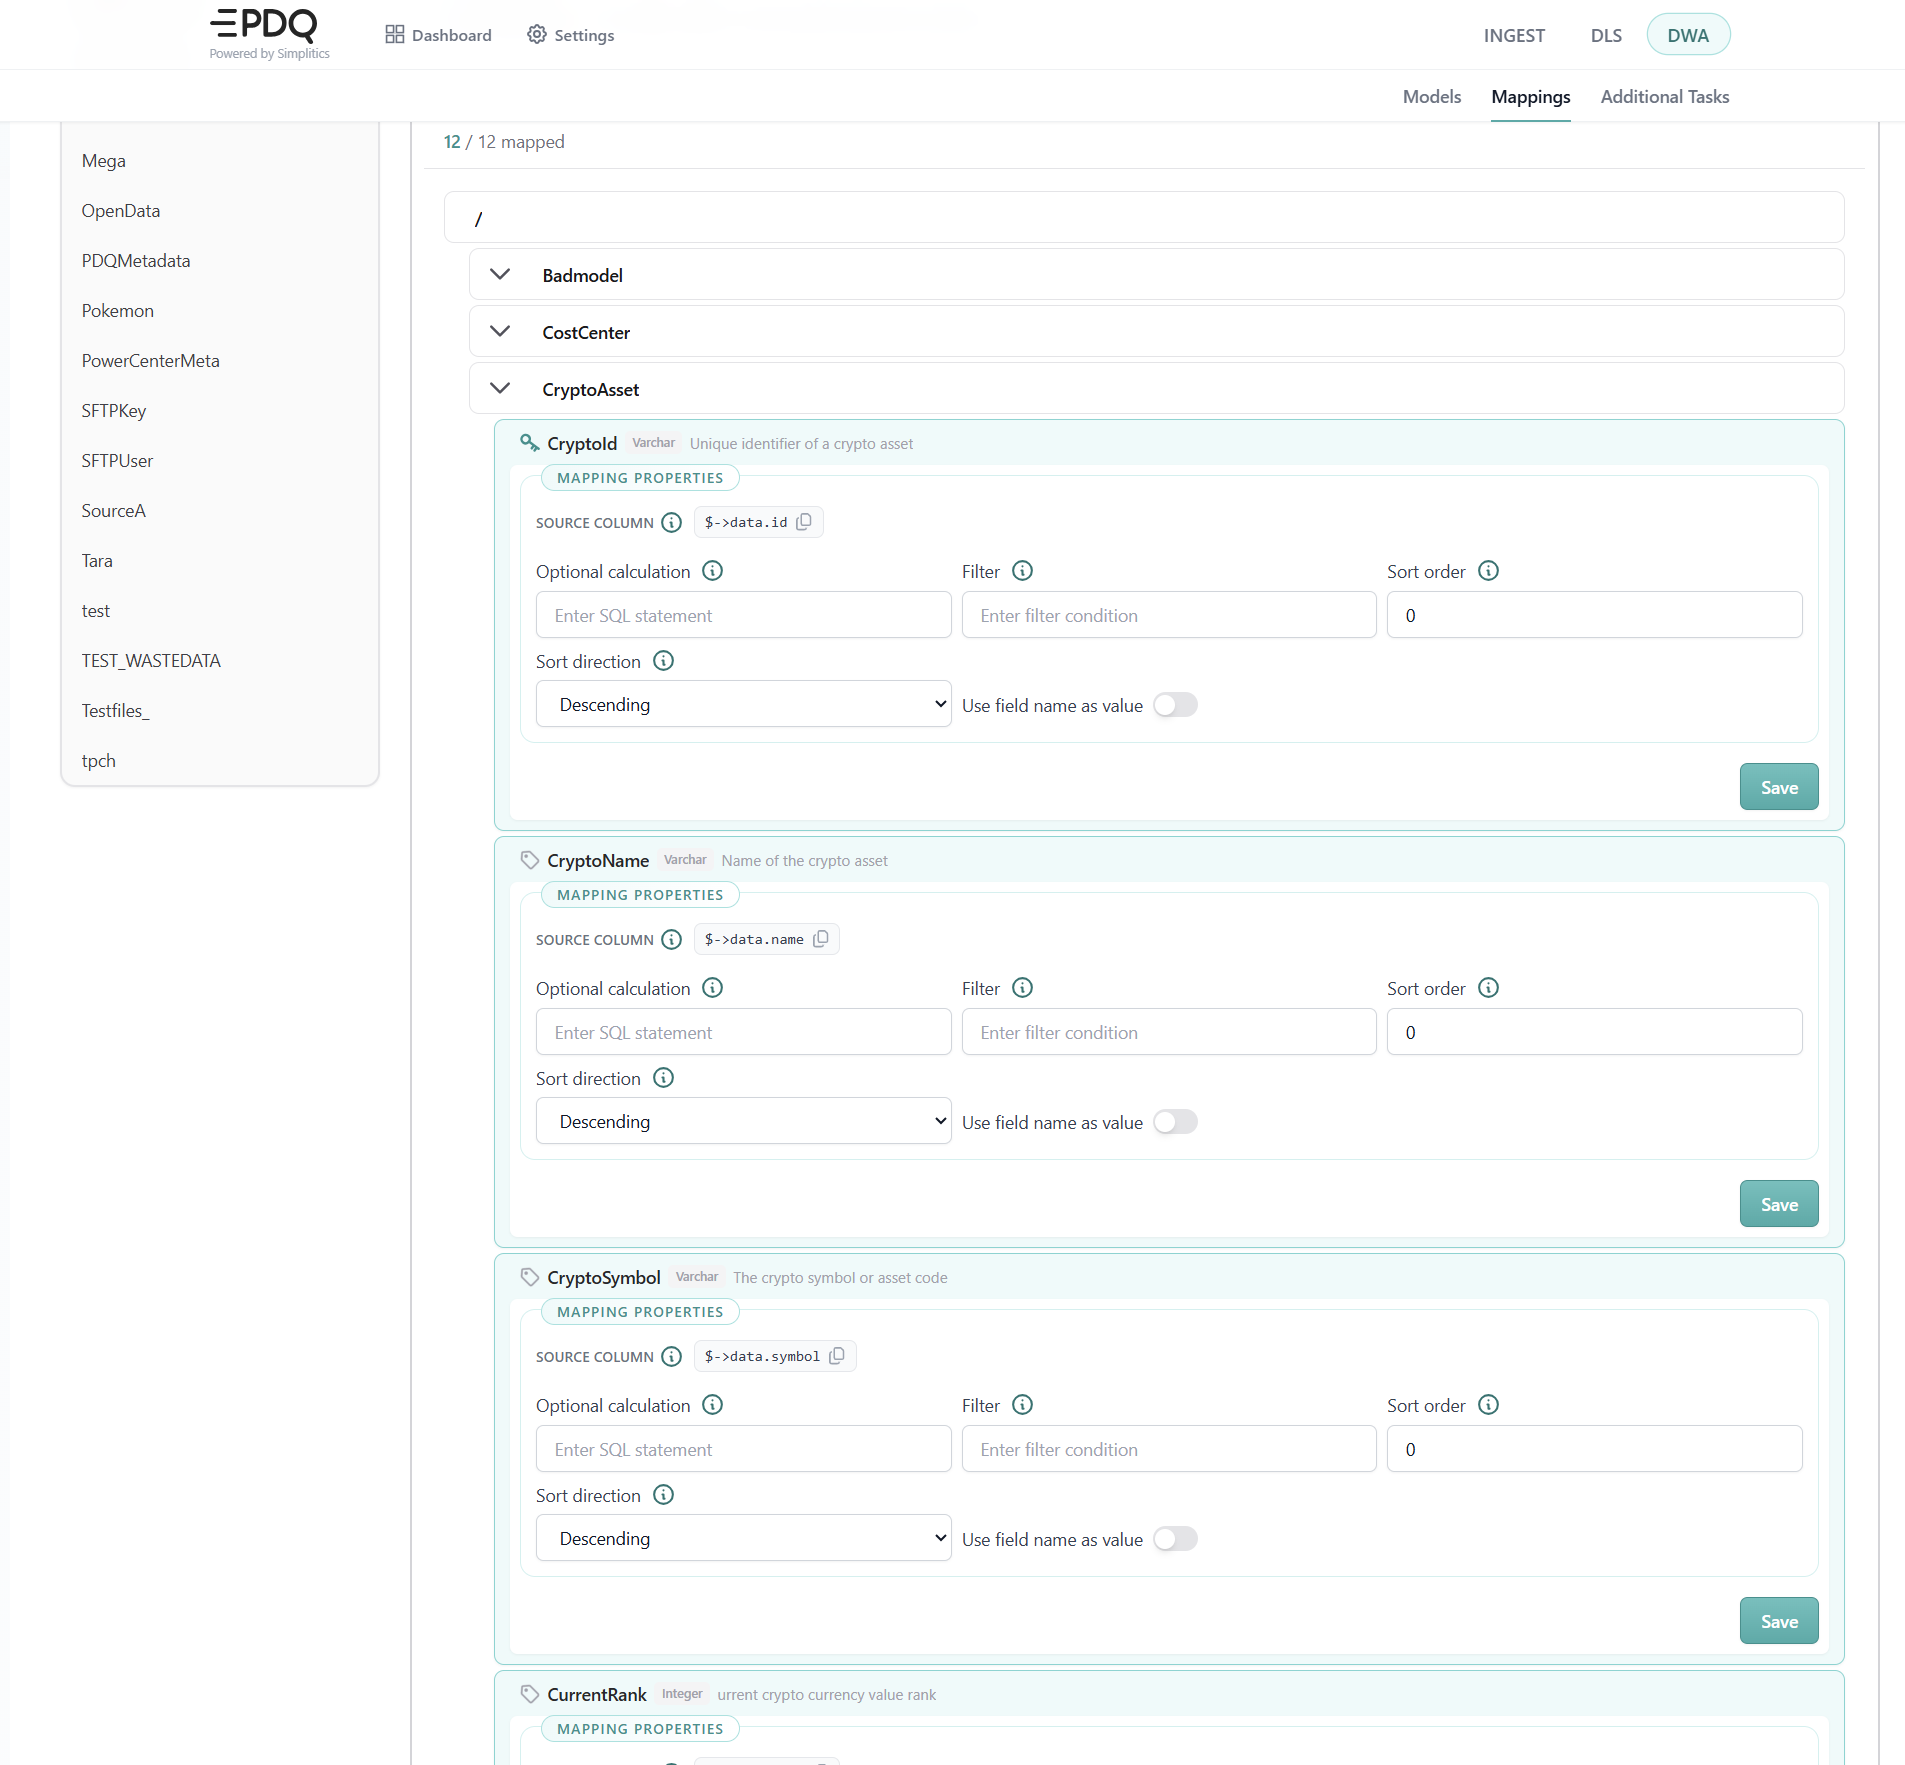
Fliken Mapping Properties konfigurerar transformationsreglerna för varje mappat attribut, bredvid den skrivskyddade källkolumn som mappningen löser till. Dessa inställningar gick tidigare bara att nå via API:et eller en källkodsvy; de går nu att redigera direkt i UI:t. Varje attribut har sin egen Save-knapp.
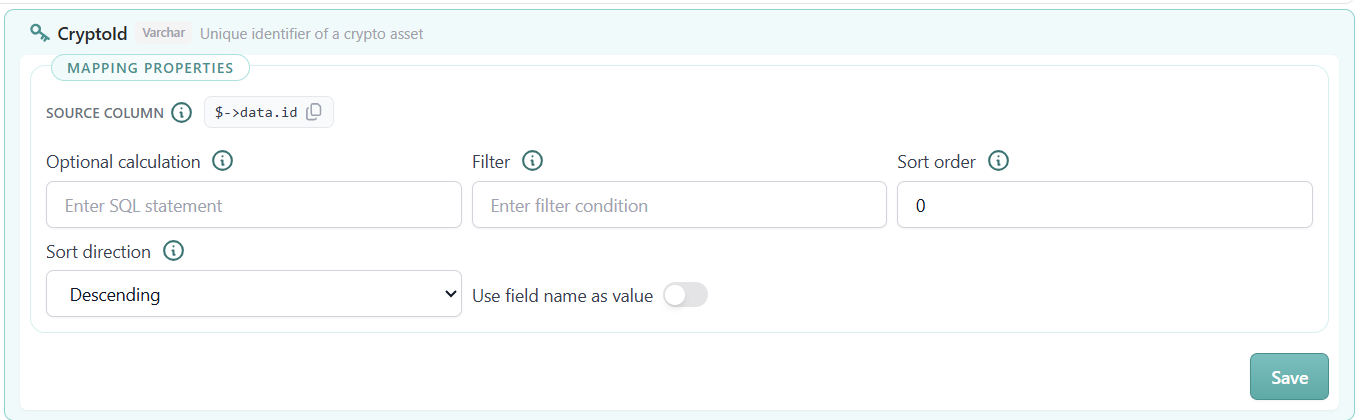
Hela fliken listar varje attribut i varje modell i mappningsgruppen, med en räknare för mappade attribut högst upp:
Optional calculation (optionalCalculation)
Kolumnberäkningar transformerar data under laddningen. Skriv vanlig SQL för en operation på en enda kolumn — den del du skulle skriva efter SELECT. Den är dialektkänslig och är kanske inte portabel mellan databasplattformar.
Syntaxen kräver källans fieldKey i skiftlägeskänslig form, som motorn ersätter med den funktionella koden för det faktiska källfältet. Detta är inte samma sak som värdet i attributets källa: använd bara det sista segmentet efter punkten. Panelen visar den mappade källkolumnen (levelPath.FieldKey) med en kopieringsknapp så att du kan lyfta rätt namn direkt ur den.
Filter (filter)
Skrivs som ett villkor i SQL-syntax — den del som skulle följa efter kolumnnamnet i en WHERE-sats. För att filtrera bort null skriver du IS NOT NULL, inte WHERE ColumnName IS NOT NULL; resten av satsen genereras. Villkoret gäller en enda kolumn och är bundet till den källa som anges i det mappningsobjekt du redigerar, så varje ytterligare villkor läggs till i motsvarande mappningsobjekt.
Filter gäller för alla attribut och relationer inom samma mappningsgrupp. Om en källa innehåller två typer av transaktioner som hör hemma i olika konceptmodeller skapar du två mappningsgrupper, var och en med sitt eget filter på typkolumnen.
Sort order och sort direction (sortOrder)
Sortering är det som gör att laddningen kan följa versioner av inkommande data och bara behålla den senaste posten per affärsnyckel. Fältet Sort order är prioriteten när flera fält deltar i sorteringen, och listan Sort direction väljer stigande eller fallande. De två lagras i ett enda tecknat värde: ett positivt tal betyder fallande, ett negativt betyder stigande — 1 är första fältet i fallande ordning, -2 det andra i stigande.
Sortering fungerar bara när sorteringskolumnerna också är attribut i målmodellobjektet, så lägg till dem där först.
Use field name as value (useFieldNameAsValue)
Laddar fältets eget namn som värde i stället för dess innehåll. Användbart för roll- eller typmarkörer som ligger i källans struktur snarare än i datan.
Föräldralösa mappningar
Mappningar vars målattribut eller målmodell döpts om eller tagits bort listas i en gul banner högst upp på fliken, var och en med en Remove-knapp. De är dolda i själva trädet, så utan bannern skulle de varken gå att se eller städa bort.
Skiftlägeskänslighet och namnkonventioner
DWA laddar data utifrån konfigurationer härledda från DLS-metadatan.
- Attributen
fieldKeyochpathi källmetadatan (skapad av DLS) är skiftlägeskänsliga och måste matcha källfilerna exakt. - Om en annan namnkonvention önskas för måltabellerna (t.ex. i Published- eller Core-zonerna) hanteras det med attributen
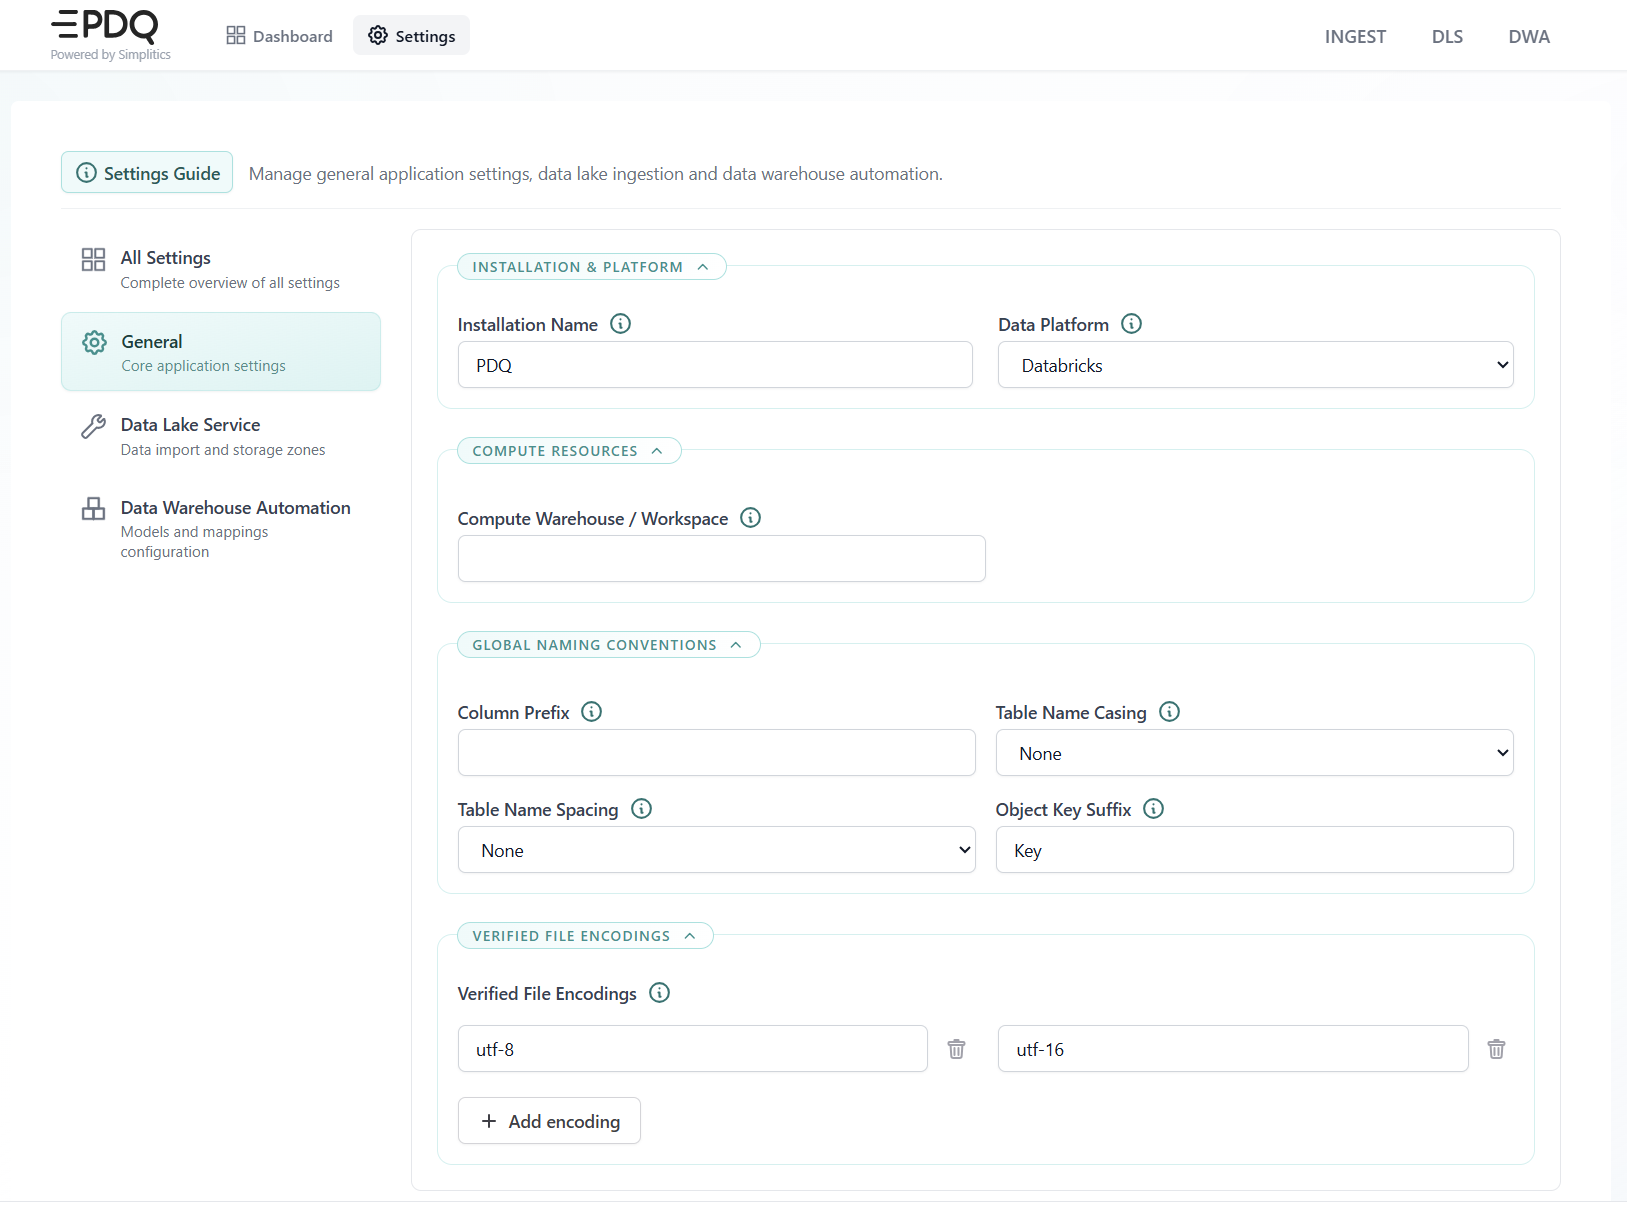
fieldAliasochlevelAliasi källfilens strukturdefinition. Dessa alias bearbetas sedan av SQL-generatorn enligt globala inställningar (somcolumnPrefixellertableNameCasing).
De globala inställningar som avses här finns under Settings → General, i avsnittet Global naming conventions. De gäller varje genererat objekt, så sätt dem innan du genererar måltabeller.
Avancerade mappningsscenarier och tekniker
Källmappningskrav som begränsar målmodellen
Ett vanligt problem är att man kan ha en välmodellerad informationsmodell, men att källan inte kan fylla affärsnycklarna i en relation korrekt. När så är fallet måste särskilda modelleringsgenvägar övervägas.
Hantera tekniska nycklar och flera källor: Relatera två olika källor med tekniska nycklar
När källan bara använder tekniska nycklar och vi behöver relatera två olika källor har vi typiskt en källfil med den tekniska nyckeln och en annan källfil där nyckeln finns tillgänglig. Lösningen är att skapa ett andra modellobjekt, med ett namn som Object_Natural_Id eller Object_Alternative_Key. Modellera sedan den affärsnyckel som förekommer över den tekniska gränsen och relatera den till det enskilda källobjektet. Ladda det modellobjektet från källfilen som innehåller båda nycklarna. Skapa en relation till det nya modellobjektet i stället för till det ursprungliga. Tricket kan tillämpas upprepade gånger och ger en generisk konstruktion som kan hålla flera identiteter för ett objekt och relatera till det från många olika källor. Nackdelen är att modellen blir något spretigare och svårare att använda i nedströmsprocesser.
Rollspelande kolumner: Relatera olika källkolumner med rollspel
Ibland behöver vi relatera olika källkolumner till ett annat objekt med någon form av rollspel. Detta stöds inte i nuvarande version på grund av strikta namnkonventioner och avsaknaden av ett generiskt sätt att beskriva roller. Det går ändå att lösa. Anta att vi har ett modellobjekt för adress, och att vårt kundobjekt har både en postadress och en fakturaadress som ska laddas och modelleras.
Ett sätt är att skapa två nya modellobjekt, Postal Address och Invoice Address, och relatera dessa till modellen Customer respektive tabellen Address. De behöver inte ha några attribut om du inte vill. Motorn förstår detta och laddar relationerna korrekt.
Ett annat sätt är att skapa ett enda "many-to-many"-modellobjekt, Address Role, och skapa en sammansatt nyckel av adressens affärsnyckel tillsammans med rollen, som antingen måste finnas i källan eller skapas i mappningen.
Hantera flera versioner av samma affärsnyckel: Behåll bara den senaste posten
Om vi har flera versioner av samma affärsnyckel i källan och bara behöver behålla den senaste posten måste sortering införas. Sortering fungerar bara när sorteringskolumnerna också finns i målobjektet. Det innebär att vi behöver lägga till attribut för dessa kolumner i varje modellobjekt där sortering ska tillämpas. Sätt sorteringsordning och riktning per attribut på fliken Mapping Properties.
På sidan DWA → Additional Tasks (/additional-tasks) definierar du extra bearbetningssteg som körs som en del av pipelinen runt de genererade laddningarna. Uppgifterna listas i en sökbar sidopanel och var och en har fyra inställningar.
Inställningar för en uppgift
- Post-processing — körs efter att data laddats in i datalagret, till exempel datakvalitetskontroller, aggregeringar eller notifieringar.
- Datamart — körs som en del av datamart-bygget, till exempel materialiserade vyer eller rapportdatamängder.
- Dependencies väntar på ett flöde: uppgiften startar inte förrän de uppgifter den namnger är klara. Använd den för att hänga arbete på slutet av ett källflöde.
- Sort Order avgör ordningen inom en körning, bland uppgifter av samma typ som alla är redo att köra. Det är en skiljeregel, inte ett beroende.
- Published
- Core (Integrated)
- DM (Business)
Name: Uppgiftens namn, unikt inom miljön. Obligatoriskt.
Type: Var i pipelinen uppgiften körs.
Sort Order: Ett heltal som avgör i vilken ordning uppgifter av samma typ körs.
Dependencies: Andra uppgifter som måste vara klara innan den här startar, valda ur listan över befintliga uppgifter.
Run Command: Det faktiska kommandot eller skriptet som ska köras. Obligatoriskt.
Dependencies kontra Sort Order
De två inställningarna svarar på olika frågor, och är lätta att blanda ihop.
En uppgift utan beroenden och med hög sorteringsordning körs ändå tidigt om inget annat är redo.
QPI-kontroller på samma flöde
QPI är ramverkets datakvalitetsmotor. Den rapporterar; den blockerar inte, och den kan inte stoppa nedströms arbete. Kontrollerna är SQL-kontroller mot data i DWA, och de kan placeras på:
En QPI-kontroll är fristående, och orkestreringen kan trigga den på samma sätt som en Additional Task: efter Additional Tasks, när de källflöden den beror på är klara, eller kedjade efter varandra. Flera kontroller kan schemaläggas i följd.
QPI-kontroller skapas och administreras i DataOps-konsolen, under QPI Monitor och QPI Administration — se Datakvalitet.
DWA
Körs som flera containrar (minst 4). Byggd med Docker. Python 3.12 på Debian 12. Källkoden ligger i Bitbucket och containrarna publiceras på Docker Hub. Den kan köras i vilken containerbaserad miljö som helst; samma region som databasen är att föredra, men inget krav.
Den genererar SQL-kod från mallar för en given databas, tar JSON-baserad konfiguration som indata och skriver antingen SQL:en till disk för en separat hanteringsprocess eller kör ELT:n i databasen.
Python-beroenden, requirements.txt
requestspyodbcredissqlalchemypandaspytzpyyamlpydanticdockerboto3asn1cryptoazure-commonazure-identityazure-storage-blobazure-storage-commonazure-mgmt-resourceazure-mgmt-datalake-storeazure-datalake-storeazure-storage-queueazure-storage-file-datalakefastapisqlparseuvicorngunicorncryptographytzlocalsixtyping_extensionssentry_sdkpython-multipart
Driftsättning och körning
- Kan köras i vilken containerbaserad miljö som helst, helst i samma region som databasen, men det är inget krav.
- Genererar SQL-kod utifrån mallar för en given databas. Den använder JSON-baserad konfiguration som indata och skriver antingen SQL till disk för en separat hanteringsprocess, eller kör ELT direkt i databasen.